分布式协议与算法实战
InfluxDB 是一个开源的时序数据库系统,当然,开源的只是单机版本,如果要使用集群功能,要么就是基于开源版本自研,要么就是购买人家的企业版本。
企业版本一个节点一年 License 授权费就是 1.5 万美刀,是不是很贵?那贵在哪里呢?相比于单机版本,企业版本的技术壁垒又是什么?
它的护城河就是以分布式算法为核心的分布式集群能力。
理论篇
搞懂分布式架构设计核心且具有“实践指导性”的基础理论,这里面会涉及典型的分布式问题,以及如何认识分布式系统中相互矛盾的特性,帮助你在实战中根据场景特点选择适合的分布式算法。
分布式算法是比较新的,快速发展的。比如,1989 年莱斯利·兰伯特(Leslie Lamport)提出了 Paxos,2006 年,谷歌研发团队让 Paxos 在生产环境中落地,但是 Paxos 缺乏编程实现的必须细节,最终的算法实现仍是建立在一个未证明的算法之上。再后来,也就是到了 2013,斯坦福大学的迭戈·安加罗(Diego Ongaro)和约翰·奥斯特霍德(John Ousterhout)提出了 Raft,但是 2016 年,Raft 仍在解决成员变更的 Bug。
开发分布式系统最关键的就是根据场景特点,选择合适的算法,在一致性和可用性之间妥协折中,而妥协折中的关键就在于能否理解各算法的特点。
也就是说,我们先要弄清楚每个算法的特点是什么,适合怎样的场景,这样当你在开发分布式系统时,才能做到心中有数,游刃有余地选择适合的算法,来解决实际场景的问题。
分布式算法的四度空间
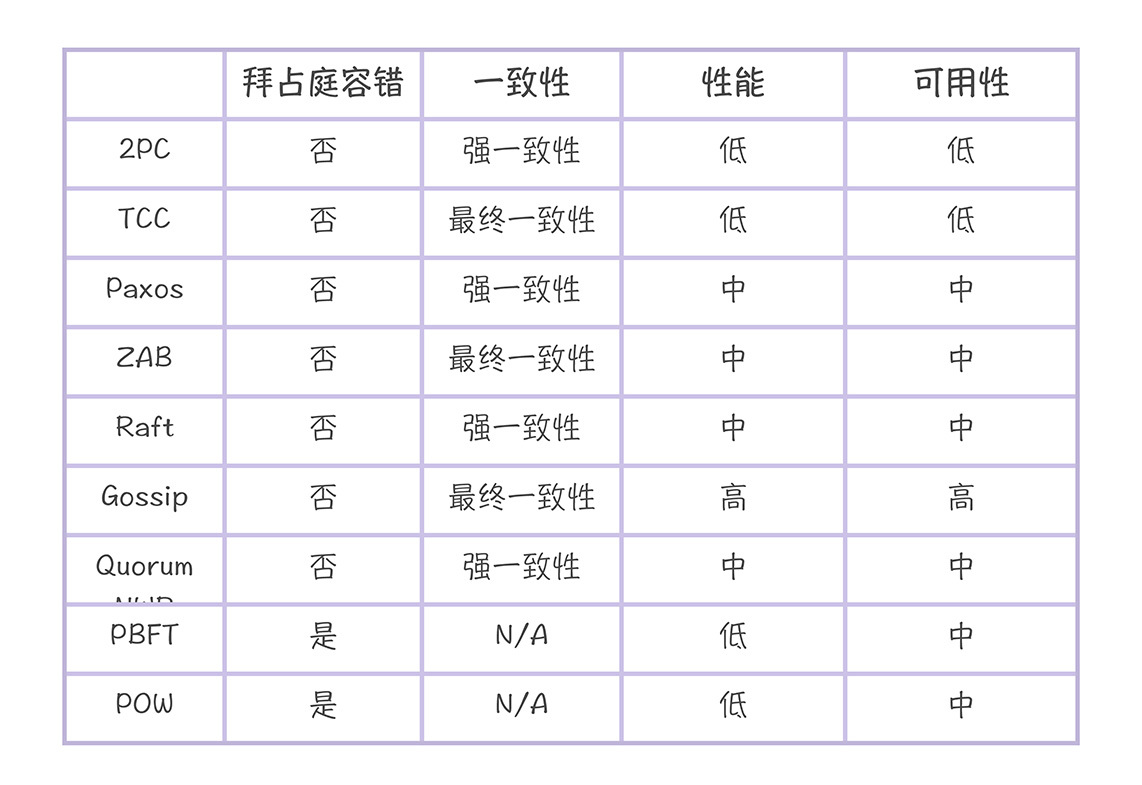
拜占庭容错
拜占庭错误是莱斯利·兰伯特在《拜占庭将军问题》中提出的一个错误模型,描述了一个完全不可信的场景,除了存在故障行为,还存在恶意行为。顾名思义,拜占庭容错(Byzantine Fault Tolerance,BFT),就是指能容忍拜占庭错误了。
而非拜占庭容错,又叫故障容错(Crash Fault Tolerance,CFT),解决的是分布式系统中存在故障,但不存在恶意节点的共识问题,比如进程崩溃、服务器硬件故障等。
一般而言,在可信环境(比如企业内网)中,系统具有故障容错能力就可以了,常见的算法有二阶段提交协议(2PC)、TCC(Try-Confirm-Cancel)、Paxos 算法、ZAB 协议、Raft 算法、Gossip 协议、Quorum NWR 算法。
而在不可信的环境(比如有人做恶)中,这时系统需要具备拜占庭容错能力,常见的拜占庭容错算法有 POW 算法、PBFT 算法。
CAP三指标
- 一致性(Consistency)
- 可用性(Availability)
- 分区容错性(Partition Tolerance)
一致性(Consistency)
一般来讲,我们将一致性分为三类。
- 强一致性:保证写操作完成后,任何后续访问都能读到更新后的值。
- 弱一致性:写操作完成后,系统不能保证后续的访问都能读到更新后的值。
- 最终一致性:保证如果对某个对象没有新的写操作了,最终所有后续访问都能读到相同的最近更新的值。
但是,强一致性是具有多种含义的。
首先,在埃里克·布鲁尔的猜想中,CAP 中的强一致性(也就是 C)是指 ACID 的 C,系统状态的一致性,而这种一致性,可以通过二阶段提交协议来实现。
其次,在 CAP 定理中,CAP 中的强一致性(也就是 C)是指原子一致性(也就是线性一致性)。其中,Paxos、Raft 能实现线性一致性,而 ZooKeeper 基于读性能的考虑,它通过 ZAB 协议提供的是最终一致性。
一般而言,在需要系统状态的一致性时,可以考虑采用二阶段提交协议、TCC。在需要数据访问时的强一致性时,可以考虑 Raft 算法。在可用性优先的系统,可以采用 Gossip 协议来实现最终一致性,并实现 Quorum NWR 来提供强一致性。
可用性(Availability)
可用性说的是任何来自客户端的请求,不管访问哪个非故障节点,都能得到响应数据,但不保证是同一份最新数据,可用性强调的是服务可用。
一般来讲,采用 Gossip 协议实现最终一致性系统,它的可用性是最高的,因为哪怕只有一个节点,集群还能在运行并提供服务。其次是 Paxos 算法、ZAB 协议、Raft 算法、Quorum NWR 算法、PBFT 算法、POW 算法,它们能容忍一定数节点故障。
最后是二阶段提交协议、TCC,只有当所有节点都在运行时,才能工作,可用性最低。
CAP不可能三角
CAP 不可能三角说的是对于一个分布式系统而言,一致性(Consistency)、可用性(Availability)、分区容错性(Partition Tolerance)3 个指标不可兼得,只能在 3 个指标中选择 2 个。
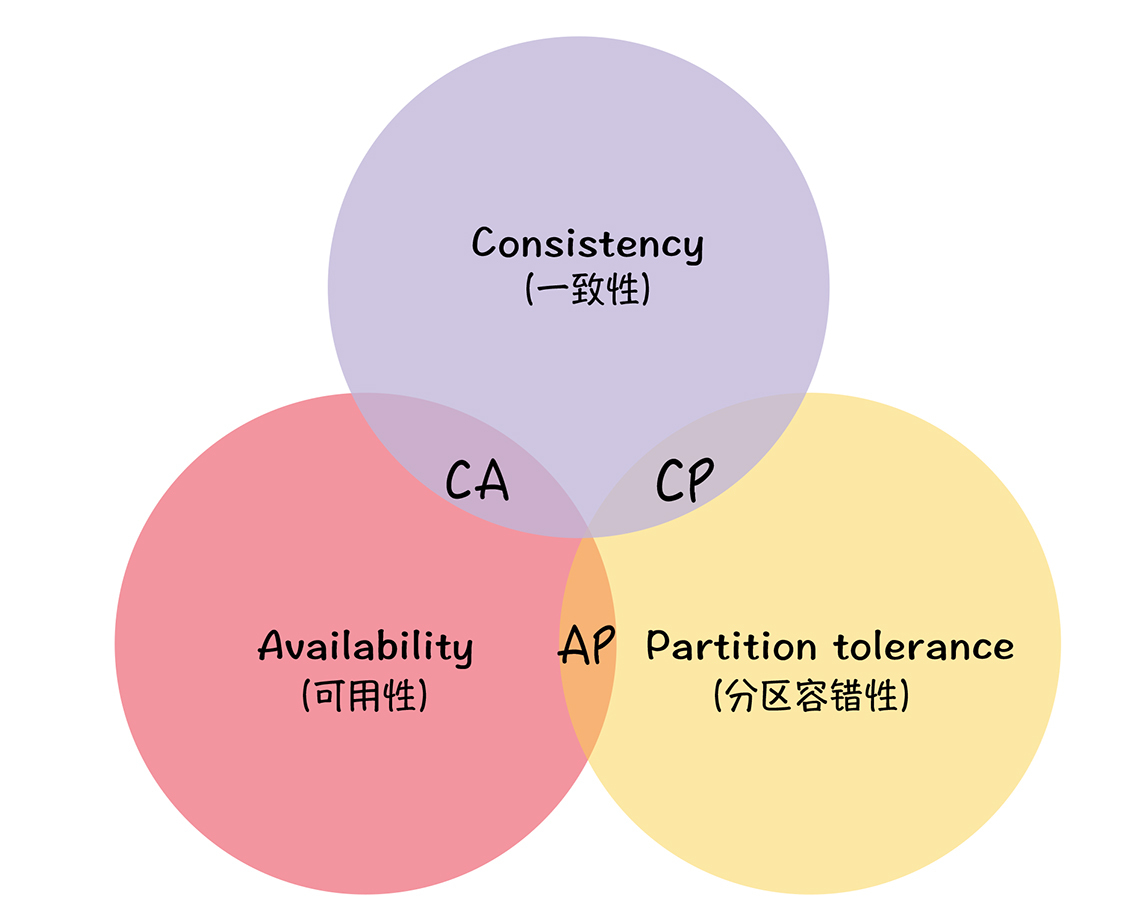
CAP 不能三角最初是埃里克·布鲁尔(Eric Brewer)基于自己的工程实践,提出的一个猜想,后被赛斯·吉尔伯特(Seth Gilbert)和南希·林奇(Nancy Lynch)证明,证明过程可以参考论文《Brewer’s conjecture and the feasibility of consistent, available, partition-tolerant web services》,你记住结论就好了。不过,为了帮你阅读论文,我补充一点:
基于证明严谨性的考虑,赛斯·吉尔伯特(Seth Gilbert)和南希·林奇(Nancy Lynch)对指标的含义做了预设和限制,比如,将一致性限制为原子一致性。
如何使用 CAP 理论
我们都知道,只要有网络交互就一定会有延迟和数据丢失,而这种状况我们必须接受,还必须保证系统不能挂掉。所以就像我上面提到的,节点间的分区故障是必然发生的。也就是说,分区容错性(P)是前提,是必须要保证的。
现在就只剩下一致性(C)和可用性(A)可以选择了:要么选择一致性,保证数据正确;要么选择可用性,保证服务可用。那么 CP 和 AP 的含义是什么呢?
- 当选择了一致性(C)的时候,一定会读到最新的数据,不会读到旧数据,但如果因为消息丢失、延迟过高发生了网络分区,那么这个时候,当集群节点接收到来自客户端的读请求时,为了不破坏一致性,可能会因为无法响应最新数据,而返回出错信息。
- 当选择了可用性(A)的时候,系统将始终处理客户端的查询,返回特定信息,如果发生了网络分区,一些节点将无法返回最新的特定信息,它们将返回自己当前的相对新的信息。
这里我想强调一点,大部分人对 CAP 理论有个误解,认为无论在什么情况下,分布式系统都只能在 C 和 A 中选择 1 个。其实,在不存在网络分区的情况下,也就是分布式系统正常运行时(这也是系统在绝大部分时候所处的状态),就是说在不需要 P 时,C 和 A 能够同时保证。只有当发生分区故障的时候,也就是说需要 P 时,才会在 C 和 A 之间做出选择。而且如果读操作会读到旧数据,影响到了系统运行或业务运行(也就是说会有负面的影响),推荐选择 C,否则选 A。
举个例子:
开源版的 InfluxDB,缺乏集群能力和可用性,而且,InfluxDB 是由 META 节点和 DATA 节点 2 个逻辑单元组成,这 2 个节点的功能和数据特点不同,需要我们分别为它们设计分区容错一致性模型。
作为分布式系统,分区容错性是必须要实现的,不能因为节点间出现了分区故障,而出现整个系统不工作的情况。
考虑到 META 节点保存的是系统运行的关键元信息,比如数据库名、表名、保留策略信息等,所以必须实现一致性。也就是说,每次读,都要能读取到最新数据,这样才能避免因为查询不到指定的元信息,时序数据记录写入失败或者系统没办法正常运行。比如,创建了数据库 telegraf 之后,如果系统不能立刻读取到这条新的元信息,那么相关的时序数据记录,就会因为找不到指定数据库信息而写入失败,所以,我选择 CAP 理论中的 C 和 P,采用 CP 架构。
DATA 节点保存的是具体的时序数据记录,比如一条记录 CPU 负载的时序数据,“cpu_usage,host=server01,location=cn-sz user=23.0,system=57.0”。虽然这些数据不是系统运行相关的元信息,但服务会被访问频繁,水平扩展、性能、可用性等是关键,所以,我选择了 CAP 理论中的 A 和 P,采用 AP 架构。
总结:
- CA 模型,在分布式系统中不存在。因为舍弃 P,意味着舍弃分布式系统,就比如单机版关系型数据库 MySQL,如果 MySQL 要考虑主备或集群部署时,它必须考虑 P。
- CP 模型,采用 CP 模型的分布式系统,舍弃了可用性,一定会读到最新数据,不会读到旧数据。一旦因为消息丢失、延迟过高发生了网络分区,就影响用户的体验和业务的可用性(比如基于 Raft 的强一致性系统,此时可能无法执行读操作和写操作)。典型的应用是 Etcd,Consul 和 Hbase。
- AP 模型,采用 AP 模型的分布式系统,舍弃了一致性,实现了服务的高可用。用户访问系统的时候,都能得到响应数据,不会出现响应错误,但会读到旧数据。典型应用就比如 Cassandra 和 DynamoDB。
性能
一般来讲,采用 Gossip 协议的 AP 型分布式系统,具备水平扩展能力,读写性能是最高的。其次是 Paxos 算法、ZAB 协议、Raft 算法,因为它们都是领导者模型,写性能受限于领导者,读性能取决于一致性实现。最后是二阶段提交协议和 TCC,因为在实现事务时,需要预留和锁定资源,性能相对低。
补充:
- 网络分区是指因为网络故障导致网络不连通,不同节点分布在不同的子网络中,各个子网络内网络正常。其实,你可以这么理解,节点之间的网络通讯出现了消息丢失、高延迟的问题。
- 分布式协议中的 ACID 是什么?
ACID 是数据库事务的四个核心特性,确保事务的可靠性和一致性:
A - Atomicity(原子性)
事务中的所有操作要么全部成功,要么全部失败。不会出现部分完成的情况。
-
例如:银行转账,要么扣款和存款都成功,要么都回滚
C - Consistency(一致性)
事务执行前后,数据库必须处于一致的状态,满足所有预定义的规则和约束。
-
例如:转账前后,两个账户的总金额保持不变
I - Isolation(隔离性)
多个事务并发执行时,每个事务都感觉不到其他事务的存在,互不干扰。
-
通常通过锁机制或多版本并发控制(MVCC)实现
-
隔离级别:读未提交、读已提交、可重复读、串行化
D - Durability(持久性)
一旦事务提交成功,其结果就会永久保存,即使系统崩溃也不会丢失。
- 通常通过写日志(WAL)和持久化存储实现
在单机上实现 ACID 也不难,比如可以通过锁、时间序列等机制保障操作的顺序执行,让系统实现 ACID 特性。在分布式系统中,实现 ACID 更具挑战性,通常需要掌握分布式事务协议,比如二阶段提交协议和 TCC(Try-Confirm-Cancel)。
二阶段提交协议
需要注意的是,在第一个阶段,每个参与者投票表决事务是放弃还是提交。一旦参与者投票要求提交事务,那么就不允许放弃事务。也就是说,在一个参与者投票要求提交事务之前,它必须保证能够执行提交协议中它自己那一部分,即使参与者出现故障或者中途被替换掉。 这个特性,是我们需要在代码实现时保障的。
还需要你注意的是,在第二个阶段,事务的每个参与者执行最终统一的决定,提交事务或者放弃事务。这个约定,是为了实现 ACID 中的原子性。
二阶段提交协议最早是用来实现数据库的分布式事务的,不过现在最常用的协议是 XA 协议。这个协议是 X/Open 国际联盟基于二阶段提交协议提出的,也叫作 X/Open Distributed Transaction Processing(DTP)模型,比如 MySQL 就是通过 MySQL XA 实现了分布式事务。
但是不管是原始的二阶段提交协议,还是 XA 协议,都存在一些问题:
- 在提交请求阶段,需要预留资源,在资源预留期间,其他人不能操作(比如,XA 在第一阶段会将相关资源锁定);
- 数据库是独立的系统。
因为上面这两点,我们无法根据业务特点弹性地调整锁的粒度,而这些都会影响数据库的并发性能。那用什么办法可以解决这些问题呢?答案就是 TCC。
TCC(Try-Confirm-Cancel)
TCC 是 Try(预留)、Confirm(确认)、Cancel(撤销) 3 个操作的简称,它包含了预留、确认或撤销这 2 个阶段。
TCC 本质上是补偿事务,它的核心思想是针对每个操作都要注册一个与其对应的确认操作和补偿操作(也就是撤销操作)。 它是一个业务层面的协议,你也可以将 TCC 理解为编程模型,TCC 的 3 个操作是需要在业务代码中编码实现的,为了实现一致性,确认操作和补偿操作必须是等幂的,因为这 2 个操作可能会失败重试。
另外,TCC 不依赖于数据库的事务,而是在业务中实现了分布式事务,这样能减轻数据库的压力,但对业务代码的入侵性也更强,实现的复杂度也更高。所以,我推荐在需要分布式事务能力时,优先考虑现成的事务型数据库(比如 MySQL XA),当现有的事务型数据库不能满足业务的需求时,再考虑基于 TCC 实现分布式事务。
补充:
幂等性,是指同一操作对同一系统的任意多次执行,所产生的影响均与一次执行的影响相同,不会因为多次执行而产生副作用。常见的实现方法有 Token、索引等。它的本质是通过唯一标识,标记同一操作的方式,来消除多次执行的副作用。
三阶段提交协议,虽然针对二阶段提交协议的“协调者故障,参与者长期锁定资源”的痛点,通过引入了询问阶段和超时机制,来减少资源被长时间锁定的情况,不过这会导致集群各节点在正常运行的情况下,使用更多的消息进行协商,增加系统负载和响应延迟。也正是因为这些问题,三阶段提交协议很少被使用,所以,你只要知道有这么个协议就可以了,但如果你想继续研究,可以参考《Concurrency Control and Recovery in Database Systems》来学习。
面试题:如果一个 transaction 的 rollback 失败了,应该怎么办?
参考答案:可以考虑这几种方式或根据场景特点结合起来使用,1. 直接重试;2. 触发告警,然后人工根据日志记录进行修复;3. 设计异步回滚流程,也就是说在一个异步流程中对账、回滚,避免因重试耗时而拖慢整体性能。
最终的一致
在我看来,最终一致性是说,系统中所有的数据副本在经过一段时间的同步后,最终能够达到一个一致的状态。也就是说,在数据一致性上,存在一个短暂的延迟。
几乎所有的互联网系统采用的都是最终一致性,只有在实在无法使用最终一致性,才使用强一致性或事务,比如,对于决定系统运行的敏感元数据,需要考虑采用强一致性,对于与钱有关的支付系统或金融系统的数据,需要考虑采用事务。
可以将强一致性理解为最终一致性的特例,也就是说,你可以把强一致性看作是不存在延迟的一致性。在实践中,你也可以这样思考: 如果业务的某功能无法容忍一致性的延迟(比如分布式锁对应的数据),需要实现的是强一致性;如果能容忍短暂的一致性的延迟(比如 QQ 状态数据),就可以考虑最终一致性。
那实现最终一致性的具体方式是什么呢?常用的有这样几种。
- 读时修复:在读取数据时,检测数据的不一致,进行修复。比如 Cassandra 的 Read Repair 实现,具体来说,在向 Cassandra 系统查询数据的时候,如果检测到不同节点的副本数据不一致,系统就自动修复数据。
- 写时修复:在写入数据,检测数据的不一致时,进行修复。比如 Cassandra 的 Hinted Handoff 实现。具体来说,Cassandra 集群的节点之间远程写数据的时候,如果写失败就将数据缓存下来,然后定时重传,修复数据的不一致性。
- 异步修复:这个是最常用的方式,通过定时对账检测副本数据的一致性,并修复(更多信息可以参考11 讲的反熵)。
在这里,我想强调的是因为写时修复不需要做数据一致性对比,性能消耗比较低,对系统运行影响也不大,所以我推荐你在实现最终一致性时优先实现这种方式。而读时修复和异步修复因为需要做数据的一致性对比,性能消耗比较多,在开发实际系统时,你要尽量优化一致性对比的算法,降低性能消耗,避免对系统运行造成影响。
另外,我还想补充一点,在实现最终一致性的时候,我推荐同时实现自定义写一致性级别(比如 All、Quorum、One、Any), 让用户可以自主选择相应的一致性级别,比如可以通过设置一致性级别为 All,来实现强一致性。
如何使用 BASE 理论
我以自研 InfluxDB 系统中 DATA 节点的集群实现为例,带你来使用 BASE 理论。咱们先来看看如何保障基本可用。
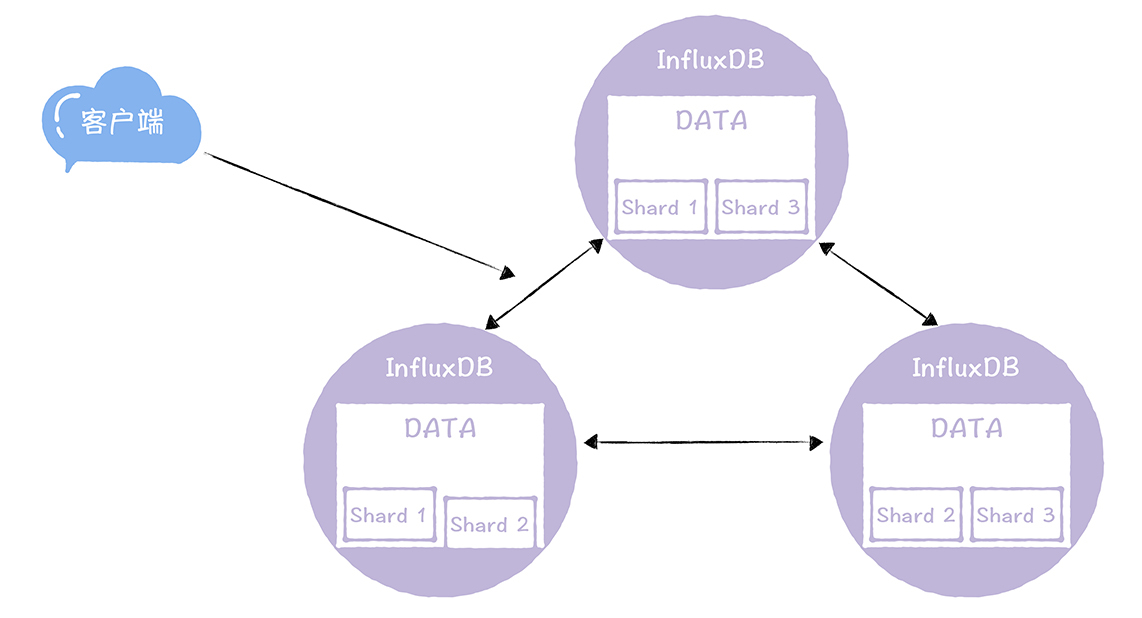
DATA 节点的核心功能是读和写,所以基本可用是指读和写的基本可用。那么我们可以通过分片和多副本,实现读和写的基本可用。也就是说,将同一业务的数据先分片,然后再以多份副本的形式分布在不同的节点上。比如下面这张图,这个 3 节点 2 副本的集群,除非超过一半的节点都故障了,否则是能保障所有数据的读写的。
那么如何实现最终一致性呢?就像我上文提到的样子,我们可以通过写时修复和异步修复实现最终一致性。另外,还实现自定义写一致性级别,支持 All、Quorum、One、Any 4 种写一致性级别,用户在写数据的时候,可以根据业务数据的特点,设置不同的写一致性级别。
- BASE 理论是对 CAP 中一致性和可用性权衡的结果,它来源于对大规模互联网分布式系统实践的总结,是基于 CAP 定理逐步演化而来的。它的核心思想是,如果不是必须的话,不推荐实现事务或强一致性,鼓励可用性和性能优先,根据业务的场景特点,来实现非常弹性的基本可用,以及实现数据的最终一致性。
- BASE 理论主张通过牺牲部分功能的可用性,实现整体的基本可用,也就是说,通过服务降级的方式,努力保障极端情况下的系统可用性。
- ACID 理论是传统数据库常用的设计理念,追求强一致性模型。BASE 理论支持的是大型分布式系统,通过牺牲强一致性获得高可用性。BASE 理论在很大程度上,解决了事务型系统在性能、容错、可用性等方面痛点。另外我再多说一句,BASE 理论在 NoSQL 中应用广泛,是 NoSQL 系统设计的事实上的理论支撑。
协议和算法篇
掌握它们的原理、特点、适用场景和常见误区等。
实战篇
将所学知识落地,掌握分布式基础理论和分布式算法在工程实践中的应用。比如,剖析 InfluxDB 企业版的 CP 架构和 AP 架构的设计和背后的思考,以及 Raft、Quorum NWR、Anti-Entropy 等分布式算法的具体实现。