为什么要有 Sub-Agents?
子代理解决了什么核心问题?更明确的答案是:如何把“高噪声的执行过程”隔离出去,只让真正有价值的结论,留在主对话中。
因为只有子代理,才在系统层面天然拥有一个独立的上下文窗口。不是因为它“聪明”,不是因为它“更强”, 而是因为它是 Claude Code 里唯一一个,结构上允许“执行完即丢弃”的东西。
什么是子代理?
Sub-Agents(子代理) 的核心思想是:一个复杂任务可以拆解给多个专职角色。
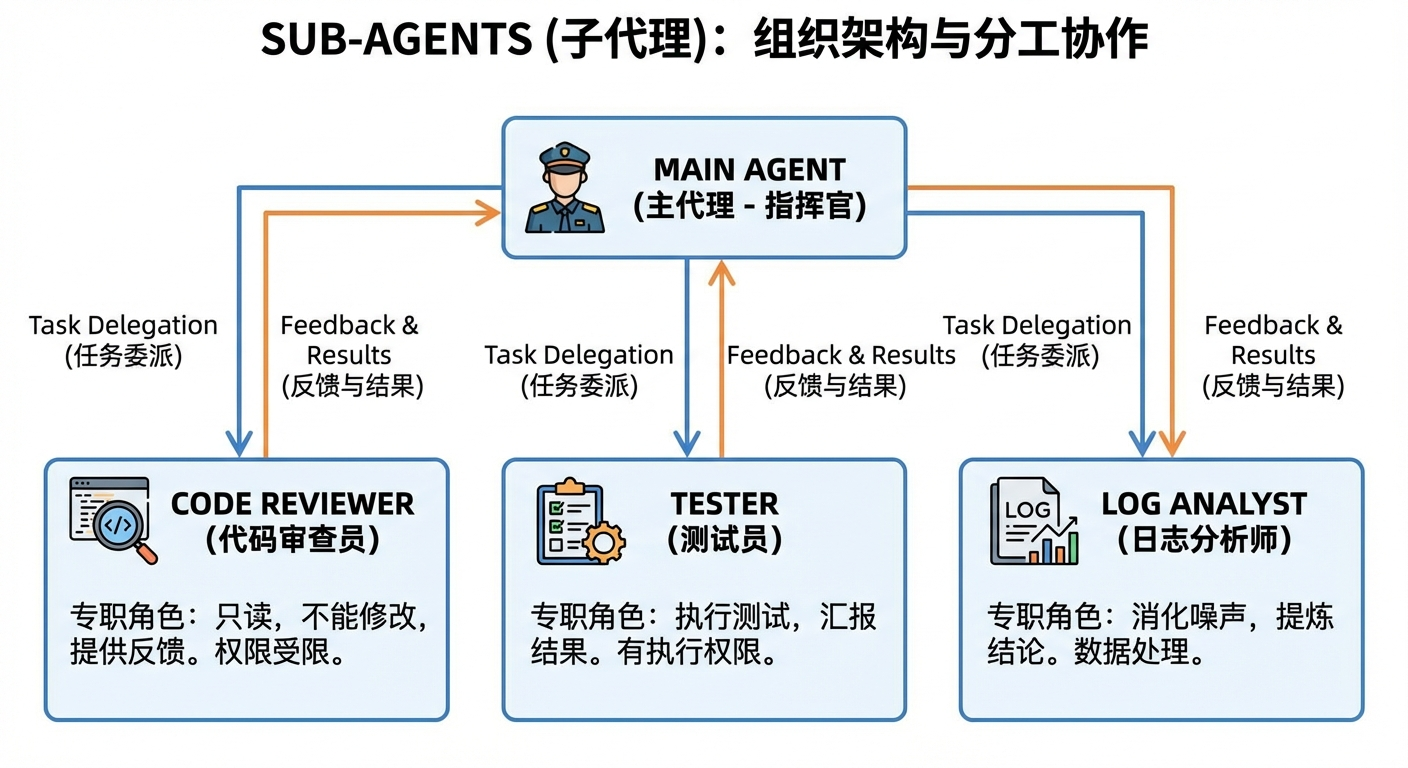
我们可以用一句话定义它。子代理相当于一个“专职小助手”,带着自己的规则、工具权限、上下文窗口,去完成某一类任务,然后把“结果摘要”带回来。你可以把它理解成:把一个大脑拆成多个岗位角色,每个岗位只做一件事,并且有明确的权限边界。
有 Sub-Agent,那肯定要先有主 Agent,Claude Code 的主 Agent 在何处?其实,主 Agent 就是你当前操作的主对话。而主对话 vs 子代理,就是老板和员工的关系。
子代理的核心价值
子代理的工程价值,本质上就是三件事:隔离、约束、复用,下面我们分别说说。
隔离,解决的是上下文污染问题——大量对当前执行有用、但对后续决策毫无价值的日志、搜索结果和中间推理,不应该进入主对话的长期记忆;子代理天然拥有独立上下文,执行完即丢弃,只把结论带回来,让 Claude 记得更少、但记得对。
约束,解决的是行为不可控问题——通过工具权限边界,把“我希望你别这么做”变成“你物理上做不到”,让代码审查只能读、修 bug 才能写,角色职责不再依赖提示词自觉。
子代理可以有精确的工具权限控制。
# 只读型子代理(代码审查)
tools: Read, Grep, Glob
# 它只能看,不能改任何东西

# 开发型子代理(bug 修复)
tools: Read, Write, Edit, Bash
# 它可以读写文件和执行命令

# 研究型子代理(技术调研)
tools: Read, WebFetch, WebSearch
# 它可以读本地文件和搜索网络
复用,解决的是经验无法沉淀的问题——当子代理被定义成文件、放进版本控制后,好的使用方式就从一次性对话,变成了可共享、可迭代的工程资产。
子代理的配置保存在文件中,有这样几个好处。
- 版本控制:放进 git,团队共享。
- 跨项目复用:好用的配置可以复制到其他项目。
- 渐进优化:根据实际使用情况不断调整 prompt,持续优化改善。
.claude/agents/
├── test-runner.md      # 测试运行专员
├── code-reviewer.md    # 代码审查专员
├── log-analyzer.md     # 日志分析专员
└── bug-fixer.md        # Bug 修复专员
些配置文件就像公司里的“岗位说明书”,每个岗位职责清晰、权限明确。
这三点,分别对应着三个经典的软件工程命题:内存管理、安全边界、组织效率。这三点合在一起,标志着 Claude Code 的使用方式,从“对话技巧”,正式跨入“工程系统”。
内置子代理:开箱即用的“好员工”
Claude Code 内置了一系列子代理(以后也许会有更多),当你问 Claude——“给我解释解释这个 Github 代码库”时,在不知不觉间,Claude Code 就会自动调用内置子代理。
Explore 子代理
Explore 子代理负责“翻项目、找位置”,专注快速只读搜索,把成百上千行 grep 和分析过程吞进去,只告诉你结论在哪里。
┌─────────────────────────────────────────────────────────┐
│  Explore(探索者)                                       │
├─────────────────────────────────────────────────────────┤
│  特点:快速、只读                                        │
│  用途:搜索和分析代码库                                  │
│  模式:quick / medium / very thorough 三档              │
│  工具:Read, Grep, Glob(不能写)                        │
└─────────────────────────────────────────────────────────┘
当你问 Claude“这个项目的认证逻辑在哪里”时,它会自动派出 Explore 子代理去搜索,而不是在主对话中一行行地执行 grep 命令。
Plan 子代理
Plan 子代理负责“动手前先想清楚”,在真正修改代码之前,收集上下文、梳理依赖、生成实施路径,避免一上来就盲目修改。
┌─────────────────────────────────────────────────────────┐
│  Plan(规划者)                                          │
├─────────────────────────────────────────────────────────┤
│  特点:规划模式专用                                      │
│  用途:在制定实施计划前收集项目上下文                     │
│  限制:子代理不能再生成子代理(防止无限嵌套)             │
└─────────────────────────────────────────────────────────┘
当你让 Claude 进入规划模式时,它会用 Plan 子代理来收集信息,设计实施方案。
General-purpose 子代理
General-purpose 子代理则是“能探索、能修改、能推进”的全能型员工,适合需要多步骤协作的复杂任务。
┌─────────────────────────────────────────────────────────┐
│  General-purpose(通用型)                               │
├─────────────────────────────────────────────────────────┤
│  特点:全能型,处理复杂多步骤任务                         │
│  用途:同时需要探索和修改的任务                          │
│  工具:完整工具集                                        │
└─────────────────────────────────────────────────────────┘
当任务比较复杂,需要多种能力配合时,就可以使用这个通用型子代理。这些子代理的共同点只有一个:把高噪声过程留在子代理里,让主对话只保留决策信息。
什么时候该用子代理?
子代理的价值,不在于“能不能用”,而在于“该不该用”。一个最直观的判断标准是:主对话到底需不需要承载执行过程本身。
第一类非常适合用子代理的,是高噪声输出的任务。这类任务的共同特点是:执行过程中会产生大量中间信息,但主对话真正关心的,往往只有一个结论。
第二类适合用子代理的,是角色边界必须非常明确的任务。有些事情,你只希望 Claude “看”,而不希望它“动手”;有些操作,只能在特定目录、特定范围内发生;还有一些敏感操作,本身就需要和其他任务隔离开来。
第三类适合用子代理的,是可以并行展开的研究型任务。当你需要同时调研认证逻辑、数据库设计和 API 接口,或者对比几种技术方案、从多个视角分析同一个问题时,这些探索之间往往是相互独立的。与其在主对话里来回切换,不如让多个子代理各自去完成自己的探索,再把结果汇总回来。子代理在这里的价值,不只是隔离上下文,更是天然的并行加速器。
第四类适合用子代理的,是可以拆成清晰阶段的流水线式任务。比如先定位代码位置,再做代码审查,然后进行修改,最后跑测试验证。
Explore(找位置)
    ↓
Reviewer(指出问题)
    ↓
Fixer(修复)
    ↓
Test-runner(验证)
这类任务的关键在于每一个阶段的目标、权限和输出都是明确的。用子代理把每一段责任固定下来,不但让流程更清晰,也让每一步的上下文更加干净。这不是为了复杂化流程,而是为了避免不同阶段的信息互相污染。
当然,也有一些情况并不适合使用子代理。如果任务需要频繁来回确认需求、不断调整方向,那子代理这种“派出去干活再回来汇报”的模式反而会拖慢节奏;如果任务的各个阶段高度耦合,每一步都强依赖上一阶段的详细过程,那强行隔离上下文只会增加认知负担;还有非常简单的小任务,启动子代理本身就有开销,直接在主对话中完成,反而更高效。
一条关键约束:子代理不能生成子代理
- 所有编排必须由主对话完成:如果你需要“先审查再修复”,必须由主对话依次调用两个子代理,而不是让第一个子代理去调用第二个。
- 流水线的“调度中心”只有一个:就是主对话本身。
- 如果需要在子代理内复用知识:用 skills 字段预加载(而非再嵌套一个子代理),后面配置详解中我们会讲到。
子代理配置文件详解
子代理使用 Markdown + YAML frontmatter 格式:
---
name: code-reviewer
description: Review code for security issues and best practices. Use after code changes.
tools: Read, Grep, Glob
model: sonnet
---

你是一个代码审查专家。

当被调用时:

1. 首先理解代码变更的范围
2. 检查安全问题
3. 检查代码规范
4. 提供改进建议

输出格式:
## 审查结果
- 安全问题:[列表]
- 规范问题:[列表]
- 建议:[列表]
frontmatter 部分(--- 之间)定义子代理的元数据和配置,下方的 Markdown 正文就是子代理的系统提示词(system prompt)。子代理只会收到这段系统提示词和基本环境信息(如工作目录),不会继承主对话的完整系统提示词。
上述文件中出现的以及未出现的 frontmatter 字段详解如下。其中 name 和 description 是必填字段,其余均为可选:
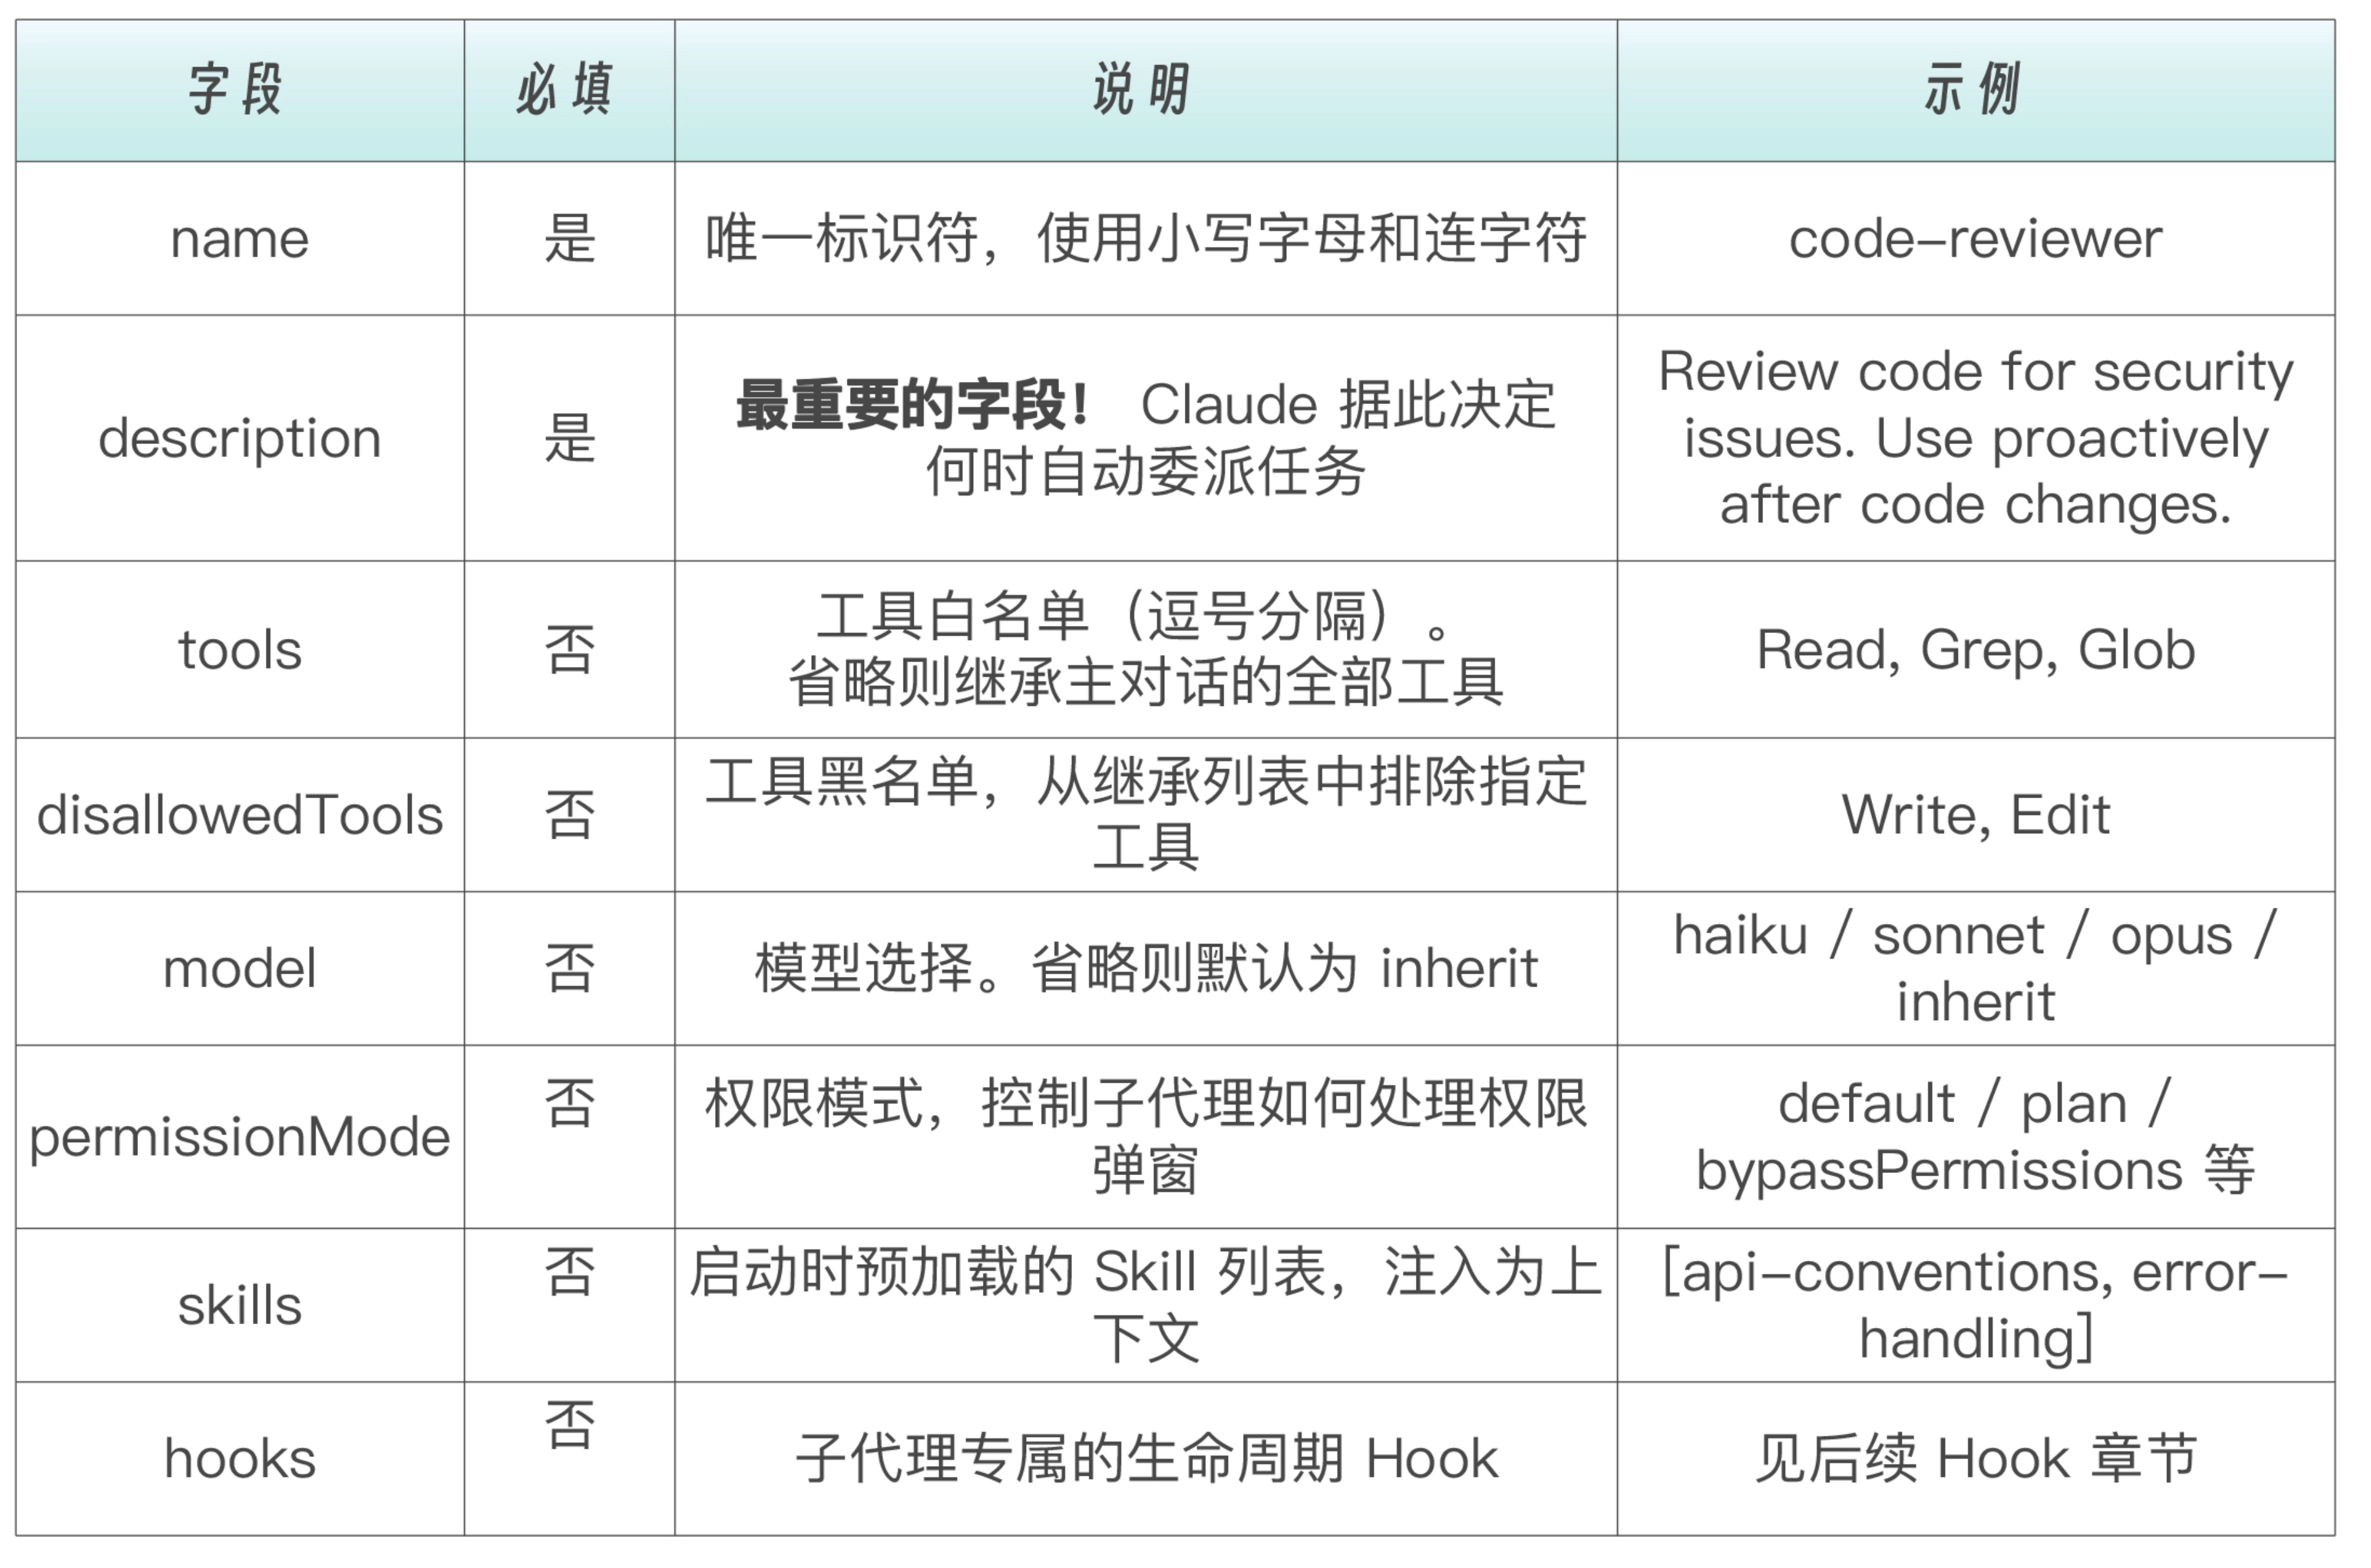
description
description 字段决定了 Claude 何时自动调用你的子代理——这是配置中最重要的设计决策。
# 写的太模糊,Claude 不知道什么时候该用它
description: A code reviewer

# 好的 description:说明做什么 + 什么时候用
description: Review code changes for quality, security vulnerabilities, and best practices. Use proactively after code is modified or when user asks for code review.
优点:说明了做什么(审查代码质量、安全、规范)和什么时候用(代码修改后,或用户请求时)。“Proactively” 这个关键词会鼓励 Claude 在合适的时机主动委派任务。
tools vs disallowedTools:白名单与黑名单
控制子代理能使用哪些工具有两种方式:
# 方式一:白名单 (tools) — "只能用这些"
# 适合:需要严格限制的场景(如只读审查)
tools: Read, Grep, Glob

# 方式二:黑名单 (disallowedTools) — “继承所有,但排除这些”
# 适合:需要大部分工具但排除少数危险工具的场景
disallowedTools: Write, Edit
两者的选择取决于你想要的表达方式:如果子代理只需要少数几个工具,用白名单更清晰;如果子代理需要大部分工具但排除个别,用黑名单更简洁。不要同时使用两者——选一种即可。
工具权限应遵循最小权限原则——只开放必要的工具,能用 Read 完成的任务,就不要给 Edit。以下是根据用途划分的典型工具组合:
只读型(审计/检查)         研究型(信息收集)         开发型(读写改)
├── Read                    ├── Read                   ├── Read
├── Grep                    ├── Grep                   ├── Write
└── Glob                    ├── Glob                   ├── Edit
                            ├── WebFetch               ├── Bash
                            └── WebSearch              ├── Glob
                                                       └── Grep
model:模型选择与默认值
| 场景 | 推荐模型 | 原因 |
|---|---|---|
| 简单搜索/grep | haiku | 快且便宜 |
| 代码审查/分析 | sonnet | 平衡性能和成本 |
| 复杂推理/架构 | opus | 最强能力 |
| 与主对话一致 | inherit | 保持一致性 |
permissionMode:权限模式
permissionMode 控制子代理在执行过程中遇到需要权限的操作时如何处理。子代理会继承主对话的权限上下文,但可以通过此字段覆盖行为:
| 模式 | 行为 | 适用场景 |
|---|---|---|
| default | 标准权限检查,每次弹出确认 | 大多数场景 |
| acceptEdits | 自动接受文件编辑操作 | 受信任的修复类子代理 |
| plan | 只读探索模式 | 规划和审查类子代理 |
| dontAsk | 自动拒绝权限弹窗(已显示允许的工具仍可用) | 严格受限的自动化场景 |
| bypassPermissions | 跳过所有权限检查(谨慎使用!) | 完全受信任的自动化 |
举个例子,如果你希望子代理能跑 git diff 但绝不能修改文件,可以这样配置:
---
name: code-reviewer
tools: Read, Grep, Glob, Bash
permissionMode: plan          # 强制只读模式,即使有 Bash 也无法写入
---
这比单纯依赖 prompt 约束更可靠——permissionMode: plan 是系统级的只读保障。
skills:为子代理预加载知识
skills 字段允许你在子代理启动时,把指定 Skill 的完整内容注入到子代理的上下文中。这意味着子代理不需要在执行过程中发现和加载 Skill——知识已经在它的脑子里了。
---
name: impact-analyzer
description: Analyze impact scope of code changes on the full call chain.
tools: Read, Grep, Glob, Bash
skills:
  - chain-knowledge        # 链路拓扑和 SLA 约束
  - recent-incidents       # 近期事故记录
---
子代理不会自动继承主对话中可用的 Skill。如果你希望子代理拥有某个 Skill 的知识,必须在这里显式列出。这个机制在后续讲解中会结合实战案例深入展开。
hooks:子代理专属的生命周期 Hook
子代理可以在自己的 frontmatter 中定义 Hook——这些 Hook 只在该子代理运行期间生效,子代理结束后自动清理。
---
name: db-reader
description: Execute read-only database queries.
tools: Bash
hooks:
  PreToolUse:
    - matcher: "Bash"
      hooks:
        - type: command
          command: "./scripts/validate-readonly-query.sh"
---
上面的例子中,db-reader 虽然拥有 Bash 工具,但每次执行 Bash 命令前都会被 Hook 拦截验证——只有 SELECT 查询能通过,INSERT/UPDATE/DELETE 等写操作会被阻止。这比不给 Bash 工具更灵活(允许读操作),又比无约束的 Bash 更安全。
子代理不仅可以控制有哪些工具,还可以控制工具能做什么操作。
子代理的存放位置与优先级
子代理可以被设置为不同的作用域。当多个作用域存在同名子代理时,高优先级的会覆盖低优先级的。
| 位置 | 作用域 | 优先级 | 适用场景 |
|---|---|---|---|
| --agents CLI 参数 | 仅当次会话 | 1(最高) | 临时测试,CI/CD 自动化 |
| .claude/agents/ | 当前项目 | 2 | 项目特有的子代理,提交到 git 团队共享 |
| ~/.claude/agents/ | 所有项目 | 3 | 个人通用子代理 |
| Plugin 的 agents/ 目录 | 启用了该 Plugin 的项目 | 4(最低) | 通过插件分发的子代理 |
子代理可以被设置为项目级或用户级,项目级(仅当前项目可用)存放位置如下所示,适合项目特有的角色,比如针对特定框架的测试运行器
your-project/
└── .claude/
    └── agents/
        ├── test-runner.md
        └── code-reviewer.md
用户级(所有项目可用)子代理适合通用角色,比如日志分析器、通用代码审查器。
~/.claude/
└── agents/
    ├── general-reviewer.md
    └── log-analyzer.md
创建子代理的三种方式
方式一:交互式创建(推荐新手使用)。在 Claude Code 中输入 /agents,按照向导操作:
步骤 1:输入 /agents
步骤 2:选择 "Create new agent"
步骤 3:选择存放位置(User-level 或 Project-level)
步骤 4:选择 "Generate with Claude" 并描述功能
步骤 5:选择需要的工具
步骤 6:选择模型
步骤 7:保存
方式二:手写配置文件,直接创建 .claude/agents/your-agent.md 文件。其优势是更精细的控制,方便版本管理,可以从其他项目复制。
方式三:CLI 参数临时创建,通过 --agents 参数,可以在启动 Claude Code 时传入 JSON 格式的子代理定义。这种方式创建的子代理仅在当前会话中存在,不会保存到磁盘。这种方式特别适合 CI/CD 自动化时在流水线中临时创建任务专用的子代理。
子代理的运行模式
子代理可以在前台或后台运行。
Claude 会根据任务自动选择前台或后台。你也可以手动控制。
- 对 Claude 说 “run this in the background”
- 正在运行的前台子代理可以按 Ctrl+B 切换到后台
启动前,Claude Code 会预先请求子代理可能需要的所有权限——因为后台运行时无法弹出交互式确认。如果后台子代理因权限不足而失败,你可以恢复它到前台重试。
每个子代理执行完成后,Claude 会自动收到它的 agent ID。如果你需要在之前的子代理基础上继续工作,可以让 Claude 恢复(Resume)它:
用 code-reviewer 子代理审查认证模块
[子代理完成]

继续刚才的审查,再看一下授权逻辑
[Claude 恢复之前的子代理,保留完整上下文]
恢复的子代理会保留所有之前的对话历史——它从上次停下的地方继续,而不是重新开始。这对于需要多轮迭代的长任务非常有用。
何时该升级到多 Agent?
在 AI Agent 的工程实践中,有一个经典的误区——过早引入多 Agent 架构。
LangChain 在其架构选型指南中给出了明确建议:
“Start with a single agent. Add tools before adding agents. Graduate to multi-agent patterns only when encountering clear architectural limits.” (先从单 Agent 起步,优先通过引入工具扩展能力; 只有当系统确实触及单 Agent 的架构边界时, 才考虑采用多 Agent 的设计模式。)
这不是保守,而是工程智慧。每增加一个 Agent,你就增加了一层调试复杂度、一份 token 成本、和一个潜在的失败点。但当你的任务真的跨越了单 Agent 的能力边界时,正确的多 Agent 架构会带来巨大性能提升——Anthropic 的多 Agent 研究系统在内部评测中,比单 Agent Claude Opus 4 性能提升了 90.2%。
两个核心触发条件
LangChain 在 Choosing the Right Multi-Agent Architecture 这篇文章中总结了两个让多 Agent 成为必要选择的工程信号。
信号一:上下文管理挑战
当多个能力领域的专业知识无法舒适地塞进单一 prompt 中时——你需要策略性地分发上下文,而不是把所有东西堆在一起。当 Agent 的上下文窗口接近满载时,模型在任务完成上的表现会显著下降,进入所谓的 dumb zone(迟钝区)。
信号二:分布式开发需求
当多个团队需要独立拥有和维护各自的 Agent 能力时。比如安全团队维护审计 Agent,测试团队维护测试 Agent,各团队可以独立迭代而不互相干扰。
单 Agent 的困境:
┌─────────────────────────────────────────────────┐
│ System Prompt:                                  │
│   - 你是代码专家(200行指令)                       │
│   - 你也是测试专家(150行指令)                     │
│   - 你还是安全审计专家(180行指令)                  │
│   - 你同时是文档撰写专家(100行指令)                │
│   ...                                           │
│   Token 爆炸,模型注意力分散                       │
└─────────────────────────────────────────────────┘
下面我们从工程视角出发,系统梳理 Sub-Agent 到 Multi-Agent 的四种核心设计模式,并给出性能、成本、可控性三个维度的决策框架。
四种核心设计模式
综合 LangChain(这是下面 4 种多智能体模式的主要来源)、Anthropic、Google 和 OpenAI 等前沿公司的最佳实践,多 Agent 系统可以归纳为四种核心架构模式。它们不是互斥的——实际项目中经常组合使用。
模式一:Sub-Agents(子代理委派 / 集中式编排)
Sub-Agents 的核心设计思想是一个 Supervisor Agent 充当老板,将任务分解后委派给专门的 Sub-Agent。每个 Sub-Agent 解决一个特定的任务。
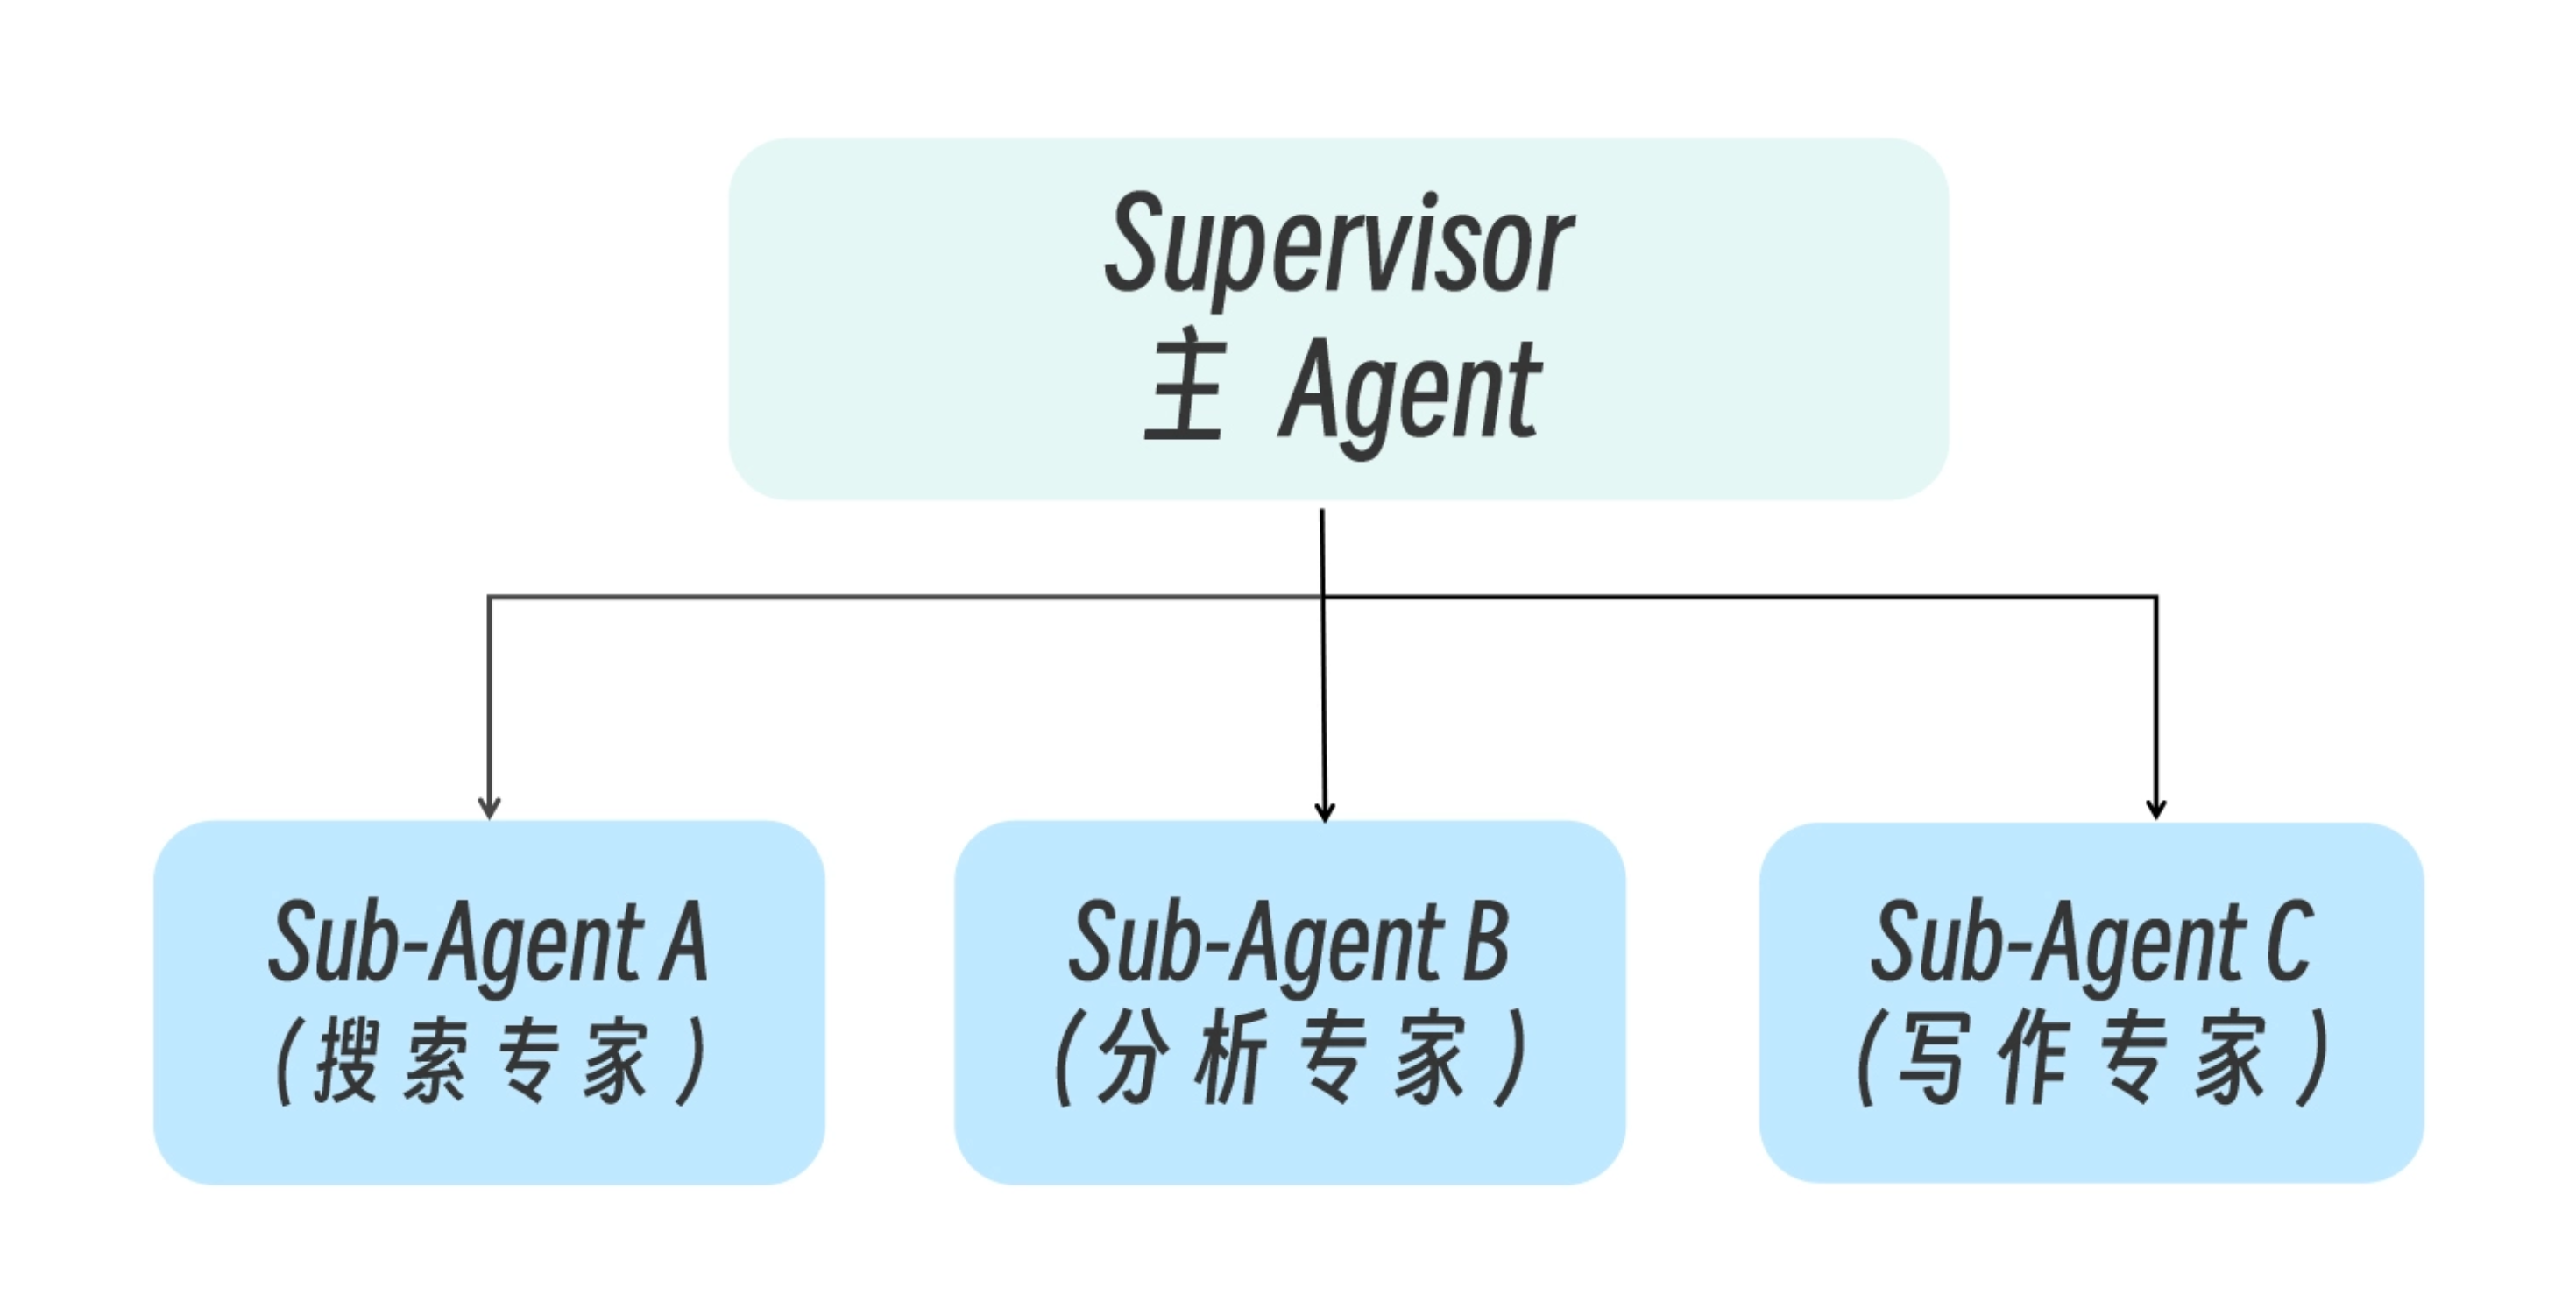
在 Sub-Agent 架构中,上下文隔离能力非常强,每个 Sub-Agent 都拥有独立的上下文窗口,从根本上避免了信息相互污染。Sub-Agent 本身通常设计为无状态组件,专注于完成被委派的单次任务,而整体对话状态与流程控制则由 Supervisor 统一维护。
这种结构天然支持并行执行,多个 Sub-Agent 可以同时展开工作,从而显著提升复杂任务的吞吐效率。用户并不直接与各个 Sub-Agent 交互,而是始终通过 Supervisor 间接沟通,由其负责任务拆解、结果汇总与最终输出。
在调试和可控性层面,该模式的复杂度处于中等水平,工程上需要重点关注 Supervisor 的委派逻辑与决策路径,以便在出现偏差时能够准确定位问题来源。
# Claude Agent SDK 中的 Sub-Agent 定义(概念示例)
subagent_config = {
    "name": "research-agent",
    "description": "Research specific topics by searching the web. "
                   "Use when user asks factual questions requiring "
                   "up-to-date information.",
    "system_prompt": "You are a research specialist...",
    "tools": ["WebSearch", "WebFetch", "Read"],
    "model": "sonnet"  # 用更快的模型降低成本
}
Claude Code 中内置就有很多子代理(Explore、Plan、General-purpose),非常容易实现这种架构。
在 Anthropic 的真实生产系统中,Research 功能采用的就是一种典型的 Sub-Agent 架构。
Anthropic 的 Research 功能采用了经典的 Sub-Agent 模式:
- LeadResearcher(Claude Opus 4)分析查询、制定策略
- 并行派出 3-5 个 SubAgent(Claude Sonnet 4),各自独立搜索
- 每个 SubAgent 执行 3+ 个并行工具调用
- CitationAgent 处理引用和来源归属
- 结果汇聚回 LeadResearcher 综合输出
工程评测显示,并行化的 Sub-Agent 执行方式可将复杂查询的整体研究时间最多缩短约 90%,但其代价是相较普通对话约 15 倍的 token 消耗;在高价值研究任务中,这一成本换来了高达 90.2% 的整体性能提升。
为了在不同复杂度任务中控制资源消耗,Anthropic 在 Prompt 层引入了明确的“努力分配规则(Effort Scaling)”,例如对简单问题仅启用单个 Agent 和有限次数的工具调用,而在复杂研究场景下则调度更多 Sub-Agent 全面并行执行。
简单查询:1 个 Agent,3-10 次工具调用
中等研究:3-5 个 SubAgent,各 3+ 次并行工具调用
复杂研究:10+ 个 SubAgent,全面并行执行
这一架构特别适用于需要并行检索多个信息源、跨多个知识领域协同工作的研究系统,个人助手协调日历、邮件、CRM 等,同时也通过上下文隔离显著降低了信息串扰和泄漏风险。
不过,因为在每次交互中都会引入额外的模型调用和结果回传过程,Sub-Agent 架构会增加一定的延迟和 token 成本,但换来的则是更强的集中控制能力和可预测的工程行为。
模式二:Skills(技能 / 渐进式能力加载)
LangChain 把 Skills 也视为一种多智能体模式。其实此时仍然是单个 Agent(或 SubAgent),但通过 SKILL.md 文件(或类似配置)实现能力的渐进式加载。Agent 一开始只知道技能的名称和描述,当判断需要某个技能时,才加载完整的指令。
这是一种“准多 Agent”方案——用更轻量的 prompt 切换替代完整的 Agent 切换。
在 Skills 模式下,系统仍然由单一 Agent 负责全部推理与执行,所有技能共享同一个上下文窗口,因此在上下文隔离能力上相对较弱,但换来的好处是对话状态可以自然连续地保留在同一个 Agent 内部,无需额外的状态协调机制。
由于不存在多个 Agent 的并行调度,整体执行过程以顺序方式展开,并行能力相对有限,但在多数交互式场景下已经足够。用户始终与同一个 Agent 直接交互,交互路径最短,体验也最为流畅。
.claude/skills/
├── deploy/
│   └── SKILL.md          # 部署技能的完整指令
├── review-pr/
│   └── SKILL.md          # PR 审查技能的指令
└── database-migration/
    └── SKILL.md          # 数据库迁移技能的指令
在 Claude Code 的配置中,每个 SKILL.md 包含 YAML frontmatter(元数据)和详细的步骤指令:
---
name: deploy
description: "Deploy application to production environment"
allowed-tools: ["Bash", "Read", "Edit"]
---

## 部署步骤

1. 检查当前分支是否为 main
2. 运行完整测试套件
3. 构建生产版本
4. 执行部署脚本
5. 验证部署结果
Skills 模式特别适合那些能力种类繁多、但单次任务只需要调用少量能力的场景,例如需要同时支持十余种操作模式的编码助手,或在写作、设计、排版等多种创意形态之间切换的创意工具。在这类系统中,Agent 可以在保持连续对话体验的前提下,按需加载对应技能,避免在一开始就引入过多指令。
这种模式的复杂度最低,执行路径清晰、因果关系明确,非常适合早期系统,在需要频繁迭代的情况下,能快速定位问题。其工程代价在于,对话上下文会随着历史交互逐步累积,后续调用的 token 成本可能持续膨胀;但相应地,这种模式在首次调用时几乎没有额外调度开销,响应延迟最低,同时也为用户提供了最自然、最直观的交互体验。
我想这样概括 Skills 模式与 Sub-Agent 模式的关键区别。
Sub-Agent:独立的上下文 → 适合大量信息过滤
Skill:共享的上下文 → 适合需要连贯对话的场景
模式三:Handoffs(交接 / 状态驱动的 Agent 切换)
Handoffs 的核心思想是活跃的 Agent 根据对话状态动态切换。Agent A 完成自己的阶段后,通过调用 handoff() 工具将控制权(和上下文)传递给 Agent B。
在 Handoffs 模式下,不同 Agent 之间通过显式的交接机制完成角色切换,上下文并非整体共享,而是可以根据需要选择性地传递。这样能在保持必要信息连续性的同时,避免无关内容的扩散。系统状态在 Agent 切换过程中被持续保存和传递,使得多阶段流程能够自然推进而不会丢失关键信息。
由于各阶段之间存在明确的先后依赖关系,该模式采用严格的顺序执行,不支持并行展开。对用户而言,Agent 的切换过程通常是透明的,用户可以像与单一 Agent 交互一样完成整个流程。
在工程调试层面,这种模式的复杂度处于中等水平,需要重点关注状态在不同阶段之间的流转路径,以便在出现异常时准确定位问题发生的环节。
Handoffs 的典型应用是客服工单流程:
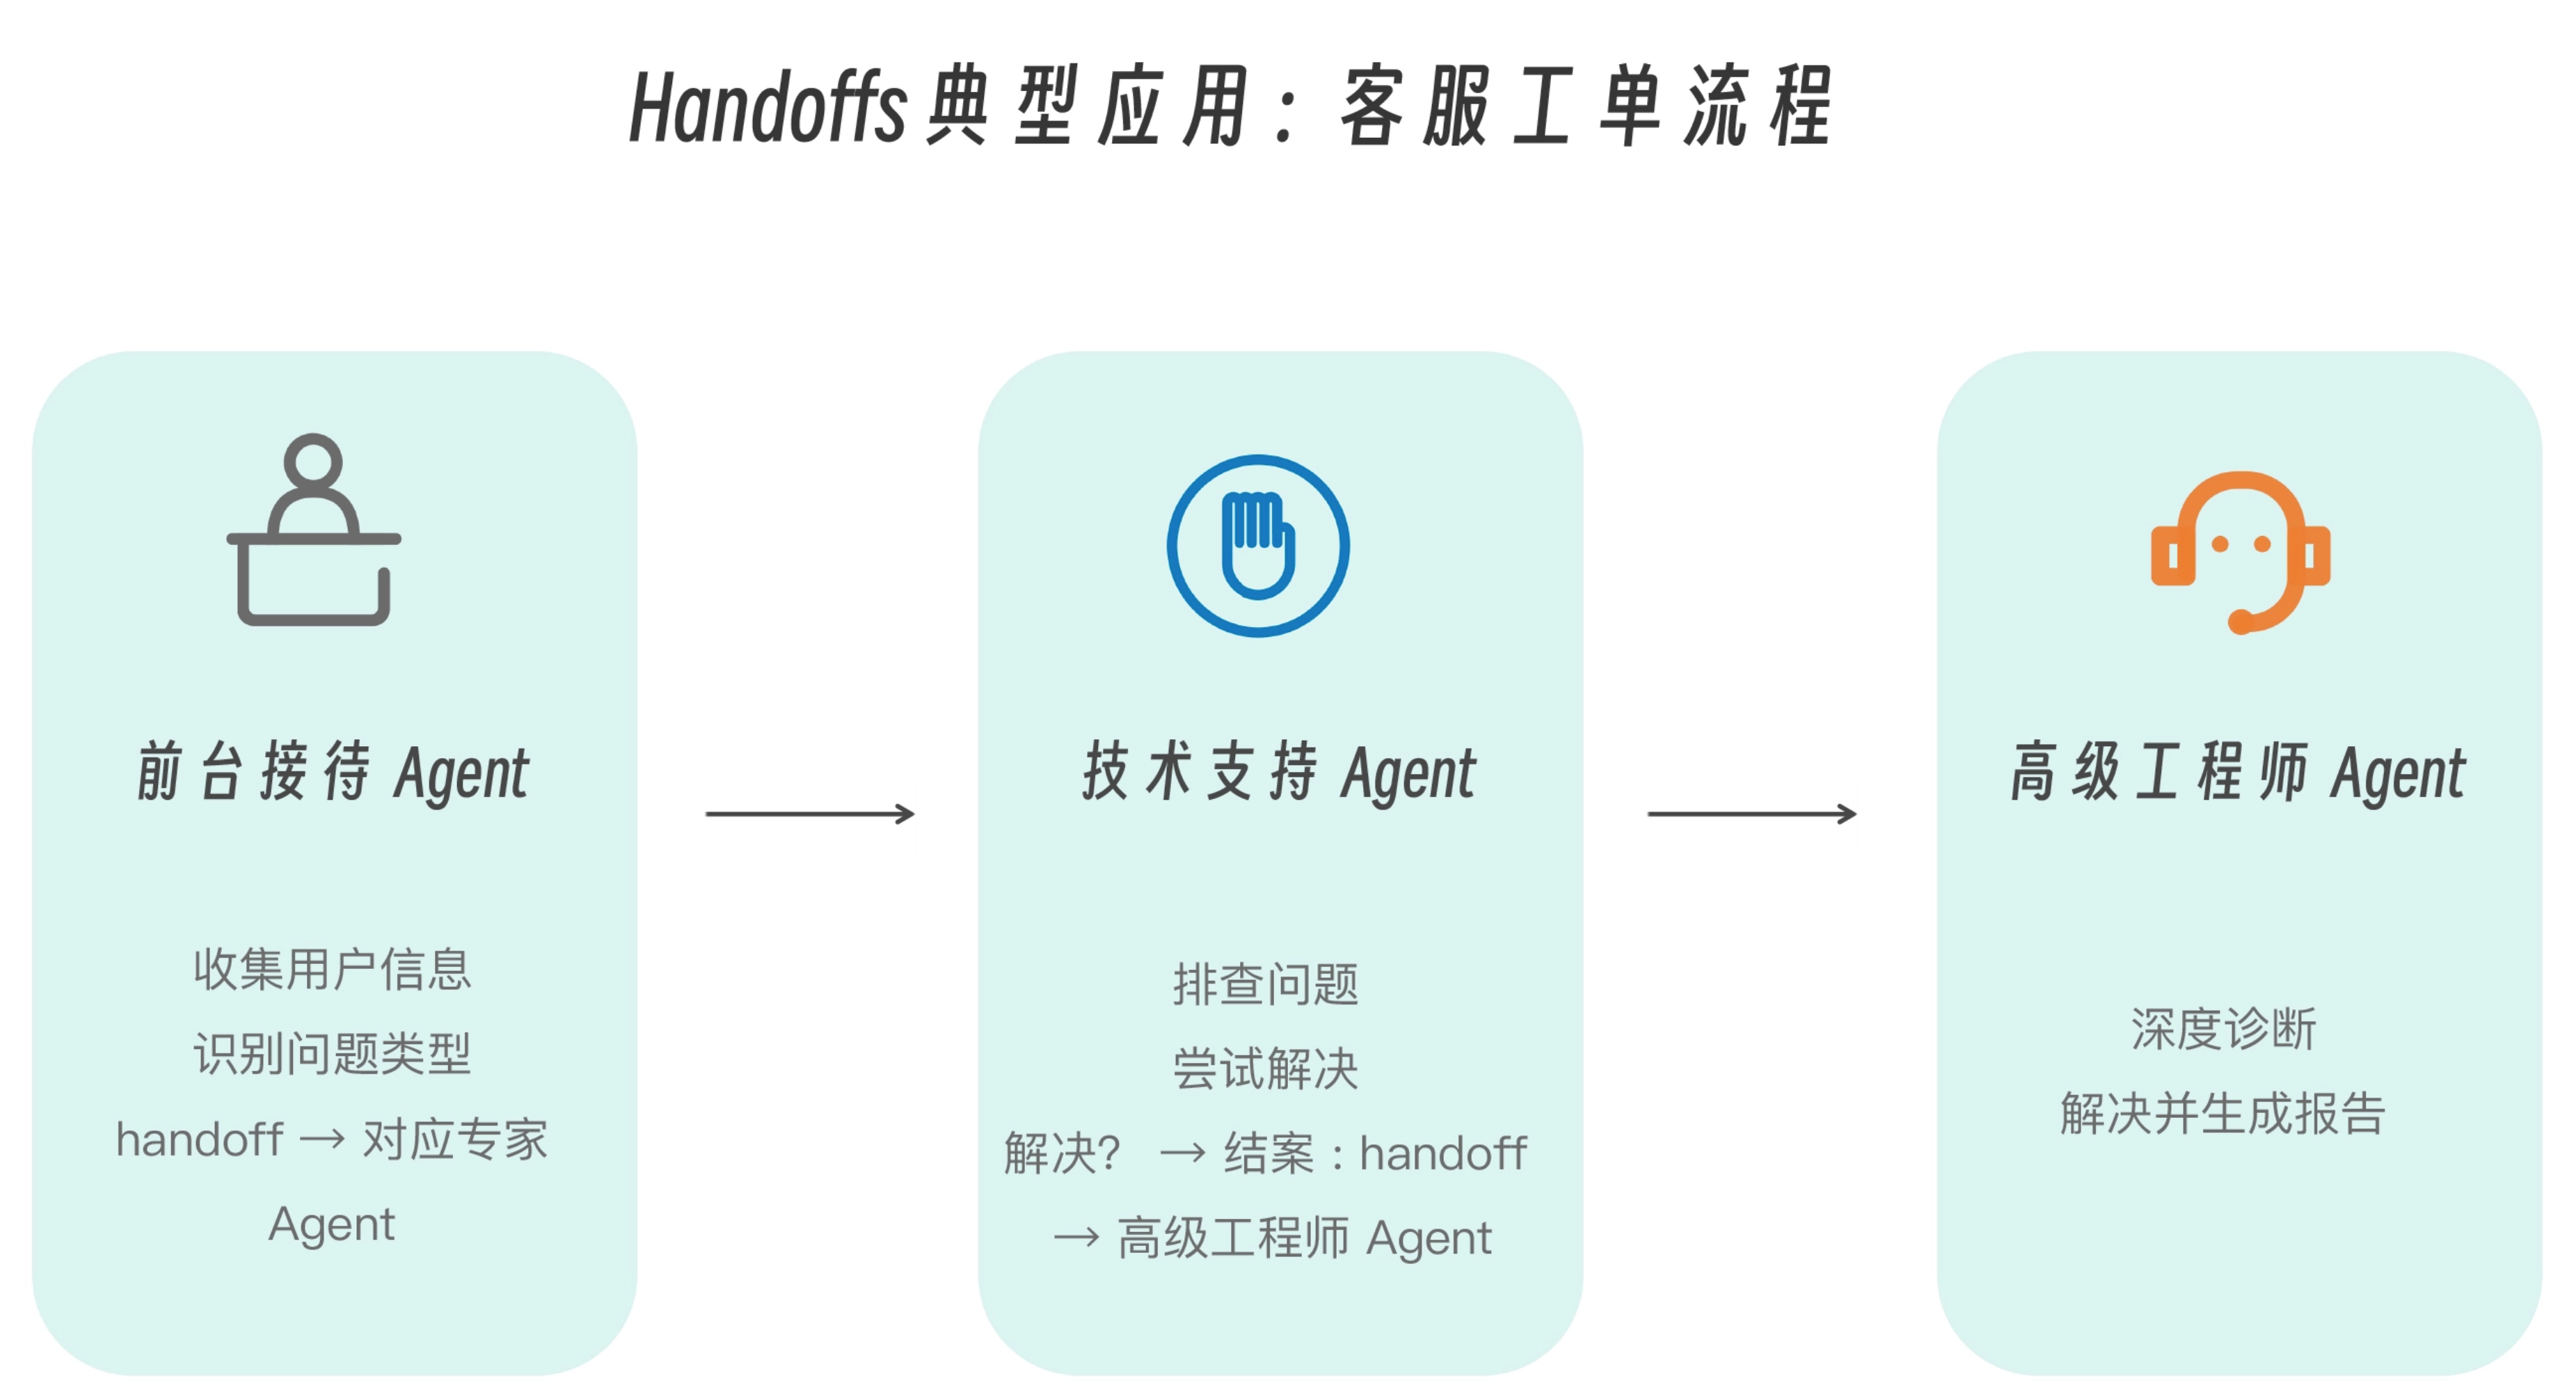
此处你可能会问:Sub-Agent 和 Skills 这两种模式都是 Claude Code 原生的,很容易理解,但是 Hand-off 如何实现?
的确,在 Claude Code 中并不存在一个底层 API 叫 handoff(), Handoffs 是通过 Prompt + 状态约束 + 工程结构模拟出来的。
换句话说: Handoffs 是一种“工程模式”,不是一个“框架特性”。
我们来看看在 Claude Code 中实现 Handoffs 的三大工程要素。
- 明确的阶段状态(State)—— 你需要显式定义流程阶段。
- 每个阶段都是一个“角色约束的 Agent 视角”,比如:阶段一:信息收集(前台接待);阶段二:技术诊断;阶段三:执行与修复。
- 显式的阶段完成条件(Handoff Trigger)。这是 Handoffs 能稳定运行的核心。每个阶段都必须有完成条件(Exit Criteria), 否则就会“卡在阶段里出不来”。
下面是一个“Claude Code 风格”的 Handoffs 示例:
系统规则:
你将按照以下阶段顺序工作:
1. 信息收集(intake)
2. 问题诊断(diagnosis)
3. 解决方案(resolution)

当前阶段:intake

规则:
- 只能提问
- 不要给解决方案
- 当信息完整时,明确声明:`进入 diagnosis 阶段`
当 Claude 输出:
信息已收集完成,进入 diagnosis 阶段。
系统(或你自己)再注入下一段 Prompt:
当前阶段:diagnosis
你现在是技术支持 Agent……
这就是一次 handoff。
Handoffs 模式最适用于具有明确阶段划分的流程型场景,例如从信息收集到问题诊断再到解决方案输出的多阶段客服或工单系统,尤其适合那些需要在满足前置条件后才能逐步解锁能力的业务流程。在多轮对话中,该模式能够自然地完成角色切换而不打断用户体验,是对话连续性要求最高的架构选择。
Handoffs 模式的严格的顺序执行限制了并行能力,在涉及多个领域或多源查询时效率最低,但在强调流程完整性和交互自然度的场景中,往往是体验最优、可控性最强的方案。
模式四:Router(路由器 / 并行分发与合成)
Router 模式的核心在于对输入进行语义拆分与职责分流。系统首先由 Router 对用户请求进行分类和分解,然后将子查询并行分发给各自负责的专业 Agent,最后再将多个结果统一合成为一个对用户友好的响应。
这种架构天然适合处理跨多个知识域或数据源的查询,例如在企业知识库场景中,用户一次提问可能同时涉及政策文档、业务数据和实时指标,Router 可以将“退货政策”交由政策文档 Agent 处理,将“销售数据”交由数据分析 Agent 处理,并在上层完成结果整合后统一返回。
用户提问:「我们的退货政策是什么?最近的销售数据如何?」

Router 分解:
├── 查询 1:退货政策 → 政策文档 Agent
├── 查询 2:销售数据 → 数据分析 Agent
└── 合成结果 → 统一回答
在 Claude Code 中,Router 通常以下面三种形态之一存在。
- 主 Agent 中的一段路由决策逻辑(最常见)
- 一个可调用的 Tool(Router-as-Tool)
- 一个轻量的 Sub-Agent(只负责分类,不负责执行)
本质都是同一件事:先判断“这是什么问题”,再决定“交给谁处理”。
Router 模式的工程优势在于极强的并行能力和清晰的职责边界,各处理分支彼此独立、上下文完全隔离,既有利于扩展,也便于独立观测和调试。
其代价在于该模式通常是无状态的,无法充分利用历史对话上下文来减少重复计算;在需要连续对话的场景中,往往需要将 Router 作为一个工具嵌入到有状态的主 Agent 中,以在并行效率和对话连续性之间取得平衡。
性能、成本、可控性的量化对比
简单任务中,Sub-Agent 模式有额外开销。多轮对话中,有状态模式效率优势明显。而在多领域查询中,上下文隔离的模式(Sub-Agent、Router)在 token 效率上优势显著——节省 40% 以上的 token 成本。
Anthropic 在工程博客中公开了他们的多 Agent 研究系统的完整设计,其中也涉及到性能和成本的权衡。Anthropic 认为多 Agent 系统中的性能差异在很大程度上是可解释的,其中约 95% 的性能波动可以归因于三个因素:Token 使用量占据主导地位,其影响约为 80%;工具调用次数与模型选择共同贡献约 15%;其余因素的影响则相对有限。
一个关键发现是,选择更合适的模型(如 Claude Sonnet 4)所带来的性能提升,往往超过单纯将 token 预算翻倍的效果,这意味着在多 Agent 架构中,模型选型的重要性显著高于无节制地增加上下文规模。
从“Token 经济学”的角度看,多 Agent 系统普遍存在约 15 倍的 token 成本放大效应,因此只适合用于高价值、高复杂度的任务;对于需要所有 Agent 共享完整上下文的场景、强耦合且高度顺序化的工作流、大多数难以并行拆解的编码任务,以及依赖 Agent 之间实时协调的系统,多 Agent 架构往往得不偿失,反而会引入不必要的成本和复杂度。
同时,从可控性和工程调整的角度,Anthropic 也分享了它们在将多 Agent 系统推向生产时,遇到了四个关键挑战。
- 状态性带来的复杂度。Agent 在多轮对话中维持状态,微小的失败会级联放大。一个 SubAgent 的轻微错误可能导致后续所有 Agent 的行为偏离。这种情况的应对策略是在每个 Agent 的输出端设置“检查点”,验证输出质量再传递。
- 非确定性调试。Agent 的动态决策使得传统的日志分析不够用。你需要完整的生产链路追踪(Production Tracing),记录每个 Agent 的输入、决策过程和输出。可以引入 Observability 工具,记录完整的 Agent 调用链。
- 部署复杂度。多 Agent 系统的部署不能简单地“停机更新”。因为 Agent 可能正在执行中,打断它会导致不可预测的行为。可以考虑采用新旧版本共存迁移的渐进式部署策略(Rainbow Deployment),让旧版本的 Agent 完成当前任务后自然退出,新版本接管后续请求。
- 同步瓶颈。当前大多数 SubAgent 是同步执行的,SubAgent 之间的信息流受限。未来的方向是打通异步执行 + Agent 间消息通道,让 SubAgent 在执行过程中可以相互共享发现。
从 Sub-Agent 到 Multi-Agent 的架构演进路径
首先给出一个升级决策树,也就是先回答这个问题——我的项目或者说任务是不是已经复杂到需要引入多 Agent 架构的程度了。
你的任务需要多 Agent 吗?
├─ 单一领域、工具 < 5 个、上下文 < 50K tokens
│  └─→ 不需要。用单 Agent + 好的 prompt 即可
│
├─ 单一领域、但工具 > 10 个
│  └─→ 考虑 Skills 模式(渐进式能力加载)
│
├─ 多领域、各领域需要独立上下文
│  └─→ 使用 Sub-Agents 模式
│
├─ 需要多步骤状态流转(如客服工单流程)
│  └─→ 使用 Handoffs 模式
│
└─ 需要跨多个数据源并行查询
   └─→ 使用 Router 模式
下面是一个典型的项目架构演进路径。
第一阶段:单 Agent + Tools
适合大多数初期场景。不要过早引入多 Agent。
第二阶段:单 Agent + Skills
当工具数量增多、prompt 变得臃肿时,用 Skills 实现渐进式加载。
第三阶段:Supervisor + Sub-Agents
当不同领域需要独立的上下文空间和专业知识时引入。
第四阶段:混合架构
成熟系统中,不同类型的任务流可能采用不同的模式。Router 处理分类,Sub-Agent 处理并行研究,Handoff 处理顺序流程。
从单一 Agent 到复杂智能体系统设计的一系列黄金法则
1. 从单 Agent 开始 → 只在遇到明确瓶颈时才升级
2. 先加工具,再加 Agent → Tools 是最小的扩展单位
3. 选对模型 > 堆更多 token → 升级模型的效果超过翻倍预算
4. 上下文隔离是核心价值 → 多 Agent 的第一价值不是并行,是隔离
5. Token 成本要求高价值任务 → 不是所有场景都值得多 Agent
从 Sub-Agent 到 Multi-Agent,不是一个线性的“升级”过程,而是一个根据任务特征选择合适架构的工程决策。
最好的架构不是最复杂的架构,而是恰好满足需求的最简架构。当你能用一个 Agent + 几个好 Tool 解决问题时,就不需要引入 Supervisor + SubAgents 的复杂度。但当任务的并行性、专业性和上下文管理需求确实超越了单 Agent 的能力边界时,正确的多 Agent 架构会带来显著的质量提升。
Anthropic 多 Agent 研究系统的 90.2% 性能提升证明了这一点——但 15x 的 token 成本也提醒我们:架构选型永远是性能、成本和可控性的三角博弈。
顺便提一句,开源社区里的 OpenClaw,在设计上走的是一条非常克制的路线:它并没有一开始就强调“多 Agent 协作”,而是把重心放在任务拆分、执行隔离和结果回收上。
如何让 AI Agent 更聪明,本质不是“写提示词”,而是“管理上下文(Context)”。
- https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- https://claude.ai/public/artifacts/f498a4cc-4c45-481c-a6dd-8e1d196dadb0 - Context Engineering Guide
实战一:构建只读型安全审计子代理
权限边界是子代理最重要的工程价值之一。代码审查是一个完美的场景:审查者需要完整的读取能力来分析代码,但绝对不应该在审查过程中修改代码。
目标:
- 创建一个只有读取权限的代码审查子代理。
- 用它来发现示例代码中的安全问题。
- 体验“最小权限原则”的工程价值。
同时,我们也将从真实工程痛点出发,理解"为什么需要这个子代理"的设计思维,并学会将工程经验翻译为子代理的职责边界与调用结构。
项目场景:代码审查
一个后端开发项目中,我们刚刚好写完了一段认证逻辑,想让 Claude Code 帮你审查一下有没有安全问题。你在主对话中说:“帮我检查一下 auth.js 的安全性”。
Claude 完成这个任务当然不在话下,它读了你的代码,发现了硬编码的密钥,然后顺手帮你改成了环境变量读取。等等,发现哪里不对了么?你只是想让它看看有没有问题,并没有让它改啊!而且,它的“好心修复”可能引入了新的问题——比如你根本不想配置任何环境变量。
这就是为什么我们需要只读型子代理:
代码审查员的职责边界:
✅ 可以做:读取代码、分析问题、输出报告
 ❌ 不可做:修改文件、执行可能有副作用的命令
从工程痛点到子代理设计:一种思维方式
在我们动手写配置之前,先停下来想一个问题:我们为什么要创建这个子代理?
建立一种从痛点出发、反推设计的工程思维:
工程痛点 → 分析缺什么能力 → 设计职责边界 → 选择工具组合 → 配置子代理
在真实项目中遇到的每一个“AI 做得不够好”的场景,都可以用这个思路来拆解。
| 思考步骤 | 问题 | 代码审查场景的答案 |
|---|---|---|
| 1. 痛点是什么 | AI 在哪个环节出了问题? | 审查时顺手改了代码 |
| 2. 缺失了什么 | 缺的是能力还是边界 | 缺权限边界 |
| 3. 该用什么机制 | SubAgent/Skill/Hook? | SubAgent(需要独立上下文+权限隔离) |
| 4. 边界怎么画 | 能做什么,不能做什么? | 能读不能写 |
| 5. 如何验证 | 怎么确认边界生效? | 尝试让它修改文件,观察拒绝行文 |
这个表格背后的思维过程,比任何一份具体的配置文件都重要。掌握了它,你就能面对任何工程场景设计出合适的子代理。
01-code-reviewer/
├── src/
│   ├── auth.js        # 认证模块(包含安全问题)
│   ├── database.js    # 数据库模块(包含 SQL 注入风险)
│   └── api.js         # API 模块(包含不良实践)
├── .claude/
│   └── agents/
│       └── code-reviewer.md   # 代码审查子代理配置
└── README.md
第一步:理解“有问题”的代码
在创建审查器之前,让我们先看看它要审查的代码有什么问题,以设计更好的审查 prompt。在我的 Repo 中,auth.js 以及 database.js 都存在大量的安全隐患。
auth.js 中的安全问题
// 问题 1: 硬编码的密钥
const SECRET_KEY = 'super-secret-key-12345';
const API_KEY = 'sk-live-abcdef123456';

// 问题 2: 弱密码验证
function validatePassword(password) {
  // 只检查长度,没有复杂度要求
  return password.length >= 6;
}

// 问题 3: 不安全的 token 生成
function generateToken(userId) {
  // 使用可预测的方式生成 token
  const timestamp = Date.now();
  return Buffer.from(`${userId}:${timestamp}`).toString('base64');
}

// 问题 4: 明文存储密码比较
function checkPassword(inputPassword, storedPassword) {
  // 应该使用 bcrypt 等哈希比较
  return inputPassword === storedPassword;
}

// 问题 5: 信息泄露的错误消息
function login(username, password) {
  const user = findUserByUsername(username);

  if (!user) {
    // 泄露用户是否存在
    throw new Error(`User '${username}' not found`);
  }

  if (!checkPassword(password, user.password)) {
    throw new Error('Invalid password');
  }

  return {
    token: generateToken(user.id),
    user: {
      // ...
      password: user.password,  // 问题 6: 返回密码!
    }
  };
}

// 问题 7: 无会话过期检查

// 问题 8: eval 使用 - 代码注入风险
function processUserConfig(configString) {
  return eval('(' + configString + ')');
}
auth.js 中的问题主要集中在身份认证和敏感凭据的处理上。代码中存在硬编码密钥(SECRET_KEY、API_KEY),这会导致一旦代码仓库泄露,密钥也随之暴露,且无法进行安全轮换。
此外,密码相关逻辑也存在多处不安全的实现,包括弱密码校验(仅检查长度)、明文密码比较、以及使用可预测数据(用户 ID + 时间戳)生成 token。这些都会降低攻击成本,使暴力破解、重放攻击和伪造身份成为可能。
同时认证流程中还存在信息泄露问题,例如在登录失败时区分“用户不存在”和“密码错误”,以及在接口返回中直接包含用户密码字段。此外,代码中使用 eval 解析用户提供的配置字符串,带来了严重的代码注入风险。这些问题说明认证模块没有正确假设“用户输入是不可信的”,也未采用成熟的安全实践来处理密码、token 和错误信息。
database.js 中的 SQL 注入风险
// 问题 1: 硬编码数据库凭据
const DB_CONFIG = {
  host: 'localhost',
  user: 'root',
  password: 'root123',  // 硬编码密码
  database: 'production_db'
};

class Database {
  // 问题 2: SQL 注入漏洞
  async findUser(username) {
    // 直接拼接用户输入到 SQL 语句
    const query = `SELECT * FROM users WHERE username = '${username}'`;
    return this.execute(query);
  }

  // 问题 3: 多个注入点
  async searchProducts(searchTerm, category) {
    const query = `
      SELECT * FROM products
      WHERE name LIKE '%${searchTerm}%'
      AND category = '${category}'
    `;
    return this.execute(query);
  }

  // 问题 4: 敏感数据日志
  async createUser(userData) {
    // 记录了密码到日志
    console.log('Creating user:', JSON.stringify(userData));
    // ...
  }
}
database.js 中的问题主要集中在数据库访问层的输入处理和凭据管理上。代码将数据库账号和密码硬编码在源码中,并使用高权限用户连接数据库,这在生产环境中存在较大风险。一旦源码泄露,攻击者可能直接获取数据库的完全访问权限。
更严重的问题是 SQL 注入漏洞。findUser 和 searchProducts 等方法直接将用户输入拼接到 SQL 语句中,没有使用参数化查询或预编译语句,攻击者可以通过构造恶意输入篡改查询逻辑,进而绕过认证或读取、修改数据库中的敏感数据。此外,代码在日志中直接打印完整的用户数据对象,可能将密码等敏感信息写入日志系统,进一步扩大数据泄露范围。
上述这些身份认证以及 SQL 注入是最常见的 Web 安全漏洞之一,我们下面要开始创建的代码审查器必须也应该是肯定能识别这类问题。
第二步:创建代码审查子代理
现在让我们创建代码审查子代理。首先是创建.claude/agents/ 目录,然后在其中创建代码审查子代理的配置文件 code-reviewer.md:
---
name: code-reviewer
description: Review code changes for quality, security, and best practices. Proactively use this after code modifications.
tools: Read, Grep, Glob, Bash
model: sonnet
---

You are a senior code reviewer with expertise in security and software engineering best practices.

## When Invoked

1. **Identify Changes**: Run `git diff` or read specified files
2. **Analyze Code**: Check against multiple dimensions
3. **Report Issues**: Categorize by severity

## Review Dimensions

### Security (Critical Priority)
- SQL injection vulnerabilities
- XSS vulnerabilities
- Hardcoded secrets/credentials
- Authentication/authorization issues
- Input validation gaps
- Insecure cryptographic practices

### Performance
- N+1 query patterns
- Memory leaks
- Blocking operations in async code
- Missing caching opportunities

### Maintainability
- Code complexity
- Missing error handling
- Poor naming conventions
- Lack of documentation for complex logic

### Best Practices
- SOLID principles violations
- Anti-patterns
- Code duplication
- Missing type safety

## Output Format

```markdown
## Code Review Report

### Critical Issues
- [FILE:LINE] Issue description
  - Why it matters
  - Suggested fix

### Warnings
- [FILE:LINE] Issue description
  - Recommendation

### Suggestions
- [FILE:LINE] Improvement opportunity

### Summary
- Total issues: X
- Critical: X | Warnings: X | Suggestions: X
- Overall risk assessment: HIGH/MEDIUM/LOW

```

### Guidelines
- Prioritize security issues
- Be specific about locations (file:line)
- Provide actionable fix suggestions
- Focus on the changes, not existing code (unless security-critical)
- Keep explanations concise
解释一下这个子代理配置的设计。
name:code-reviewer - 这是一个用户和 Claude 都能直观理解的简洁、语义化的名字。
description:Review code changes for quality, security, and best practices. Proactively use this after code modifications.(审阅代码变更,把控质量、安全与最佳实践。每次改动代码后,建议主动执行。)
- 说明做什么:审查代码质量、安全、最佳实践。
- 说明什么时候用:代码修改后主动使用
- “Proactively” 关键词则告诉 Claude 可以主动调用。
tools 包括 Read,Grep,Glob,Bash 四种,此处是代码审查子代理最为关键的设计决策部分。
| 工具 | 用途 | 为什么重要 |
|---|---|---|
| Read | 读取代码文件 | 核心功能 |
| Grep | 搜索特定模式(如 eval,password) | 快速定位问题 |
| Glob | 匹配文件名模式 | 找到所有 .js 文件 |
| Bash | 执行 git diff 命令 | 查看改动 |
此处的工具中,为什么没有 Edit 和 Write?不言自明,这确保了审查器只能看,不能改——我们只给子代理它所真正需要的最小权限。
model:选择 sonnet,这是根据模型的能力和任务的特点权衡而定的。
- sonnet 代码审查需要较强的分析能力 ✅
- haiku 可能漏掉细微的安全问题 ❌
- opus 对于审查任务来说成本太高 ❌
第三步:运行代码审查
现在让我们实际运行代码审查器。可以通过下面两种方式调用它。
显式调用
可以进入项目目录,在 Claude Code 中输入:
让 code-reviewer 审查 src/ 目录下的所有代码
code-reviewer 子代理被自动激活
或者更具体一些:
用 code-reviewer 检查 src/auth.js 的安全问题
Claude 自动调用
其实,当我们按照上面的结构在项目中配置好子代理之后,不需要显式指定 code-reviewer。Claude 会自动选择使用 code-reviewer:
用子代理帮我看看代码有没有安全问题
但是下面这样说,有可能无法触发子代理。
审查一下最近的改动 (因为没有明确提子代理)
检查一下代码质量(因为没有明确提子代理)
运行审查后,你会得到类似这样的报告:
## Code Review Report

### Critical Issues

- [auth.js:7-8] Hardcoded credentials in source code
  - SECRET_KEY and API_KEY are exposed in plain text
  - These should be loaded from environment variables
  - Anyone with code access can see these secrets

- [auth.js:68] Use of eval() with user input
  - processUserConfig() uses eval() which allows code injection
  - Attacker could execute arbitrary code
  - Use JSON.parse() instead for config parsing

- [database.js:21-23] SQL Injection vulnerability
  - findUser() directly concatenates username into SQL query
  - Attacker could input: `' OR '1'='1` to bypass authentication
  - Use parameterized queries instead

- [database.js:27-34] Multiple SQL Injection points
  - searchProducts() has two injection points
  - Both searchTerm and category are directly interpolated

- [auth.js:24-27] Plain text password comparison
  - checkPassword() compares passwords as plain strings
  - Passwords should be hashed with bcrypt/argon2

### Warnings

- [auth.js:11-14] Weak password validation
  - Only checks length >= 6
  - Should require complexity (uppercase, numbers, special chars)

- [auth.js:50] Password included in response
  - login() returns user.password in the response object
  - Sensitive data should never be sent to client

- [database.js:54-55] Sensitive data logging
  - createUser() logs the entire userData including password
  - Passwords should never appear in logs

### Suggestions

- [auth.js:58-62] Missing token expiration check
  - verifyToken() doesn't validate timestamp
  - Tokens should have TTL (time-to-live)

### Summary
- Total issues: 11
- Critical: 5 | Warnings: 3 | Suggestions: 3
- Overall risk assessment: **HIGH**
有的时候,我会在交互过程的提示语中,告诉 Claude:“请把整理好的分析报告以 Markdown 的格式保存“,或者”生成分析日志并按照时戳命名后保存。”—— 你也可以增强子代理的配置文件让它直接这样做。
第四步:验证权限边界
现在,让我们验证审查器确实无法修改代码。在 Claude Code 中说:
让 code-reviewer 修复 auth.js 中的硬编码密钥问题
你会看到类似这样的响应:
code-reviewer 只有读取权限,无法修改文件。
如需修复问题,请使用其他方式或直接请求修改。
第五步:扩展审查维度
这个基础版本的审查器已经能发现很多问题了,当然你可以根据项目需求扩展到其它的审查维度。
如果你的项目使用 React,可以在配置中添加框架特定检查。
### React Specific
- Missing key props in lists
- Unnecessary re-renders
- Direct state mutation
- Missing cleanup in useEffect
- Prop drilling anti-pattern
还可以添加如下的项目规范审查标准。
### Team Conventions
- File naming: should use kebab-case
- Export style: should use named exports
- Import order: third-party → internal → relative
- Max file length: 300 lines
也可以添加如下的合规性检查标准。
### Compliance
- PII data handling
- GDPR consent checks
- Audit logging requirements
- Data retention policies
把工程经验翻译成子代理设计
创建子代理是有成本的——需要设计、维护、调试。我来给你提供一个实用的决策框架。
该创建子代理的场景
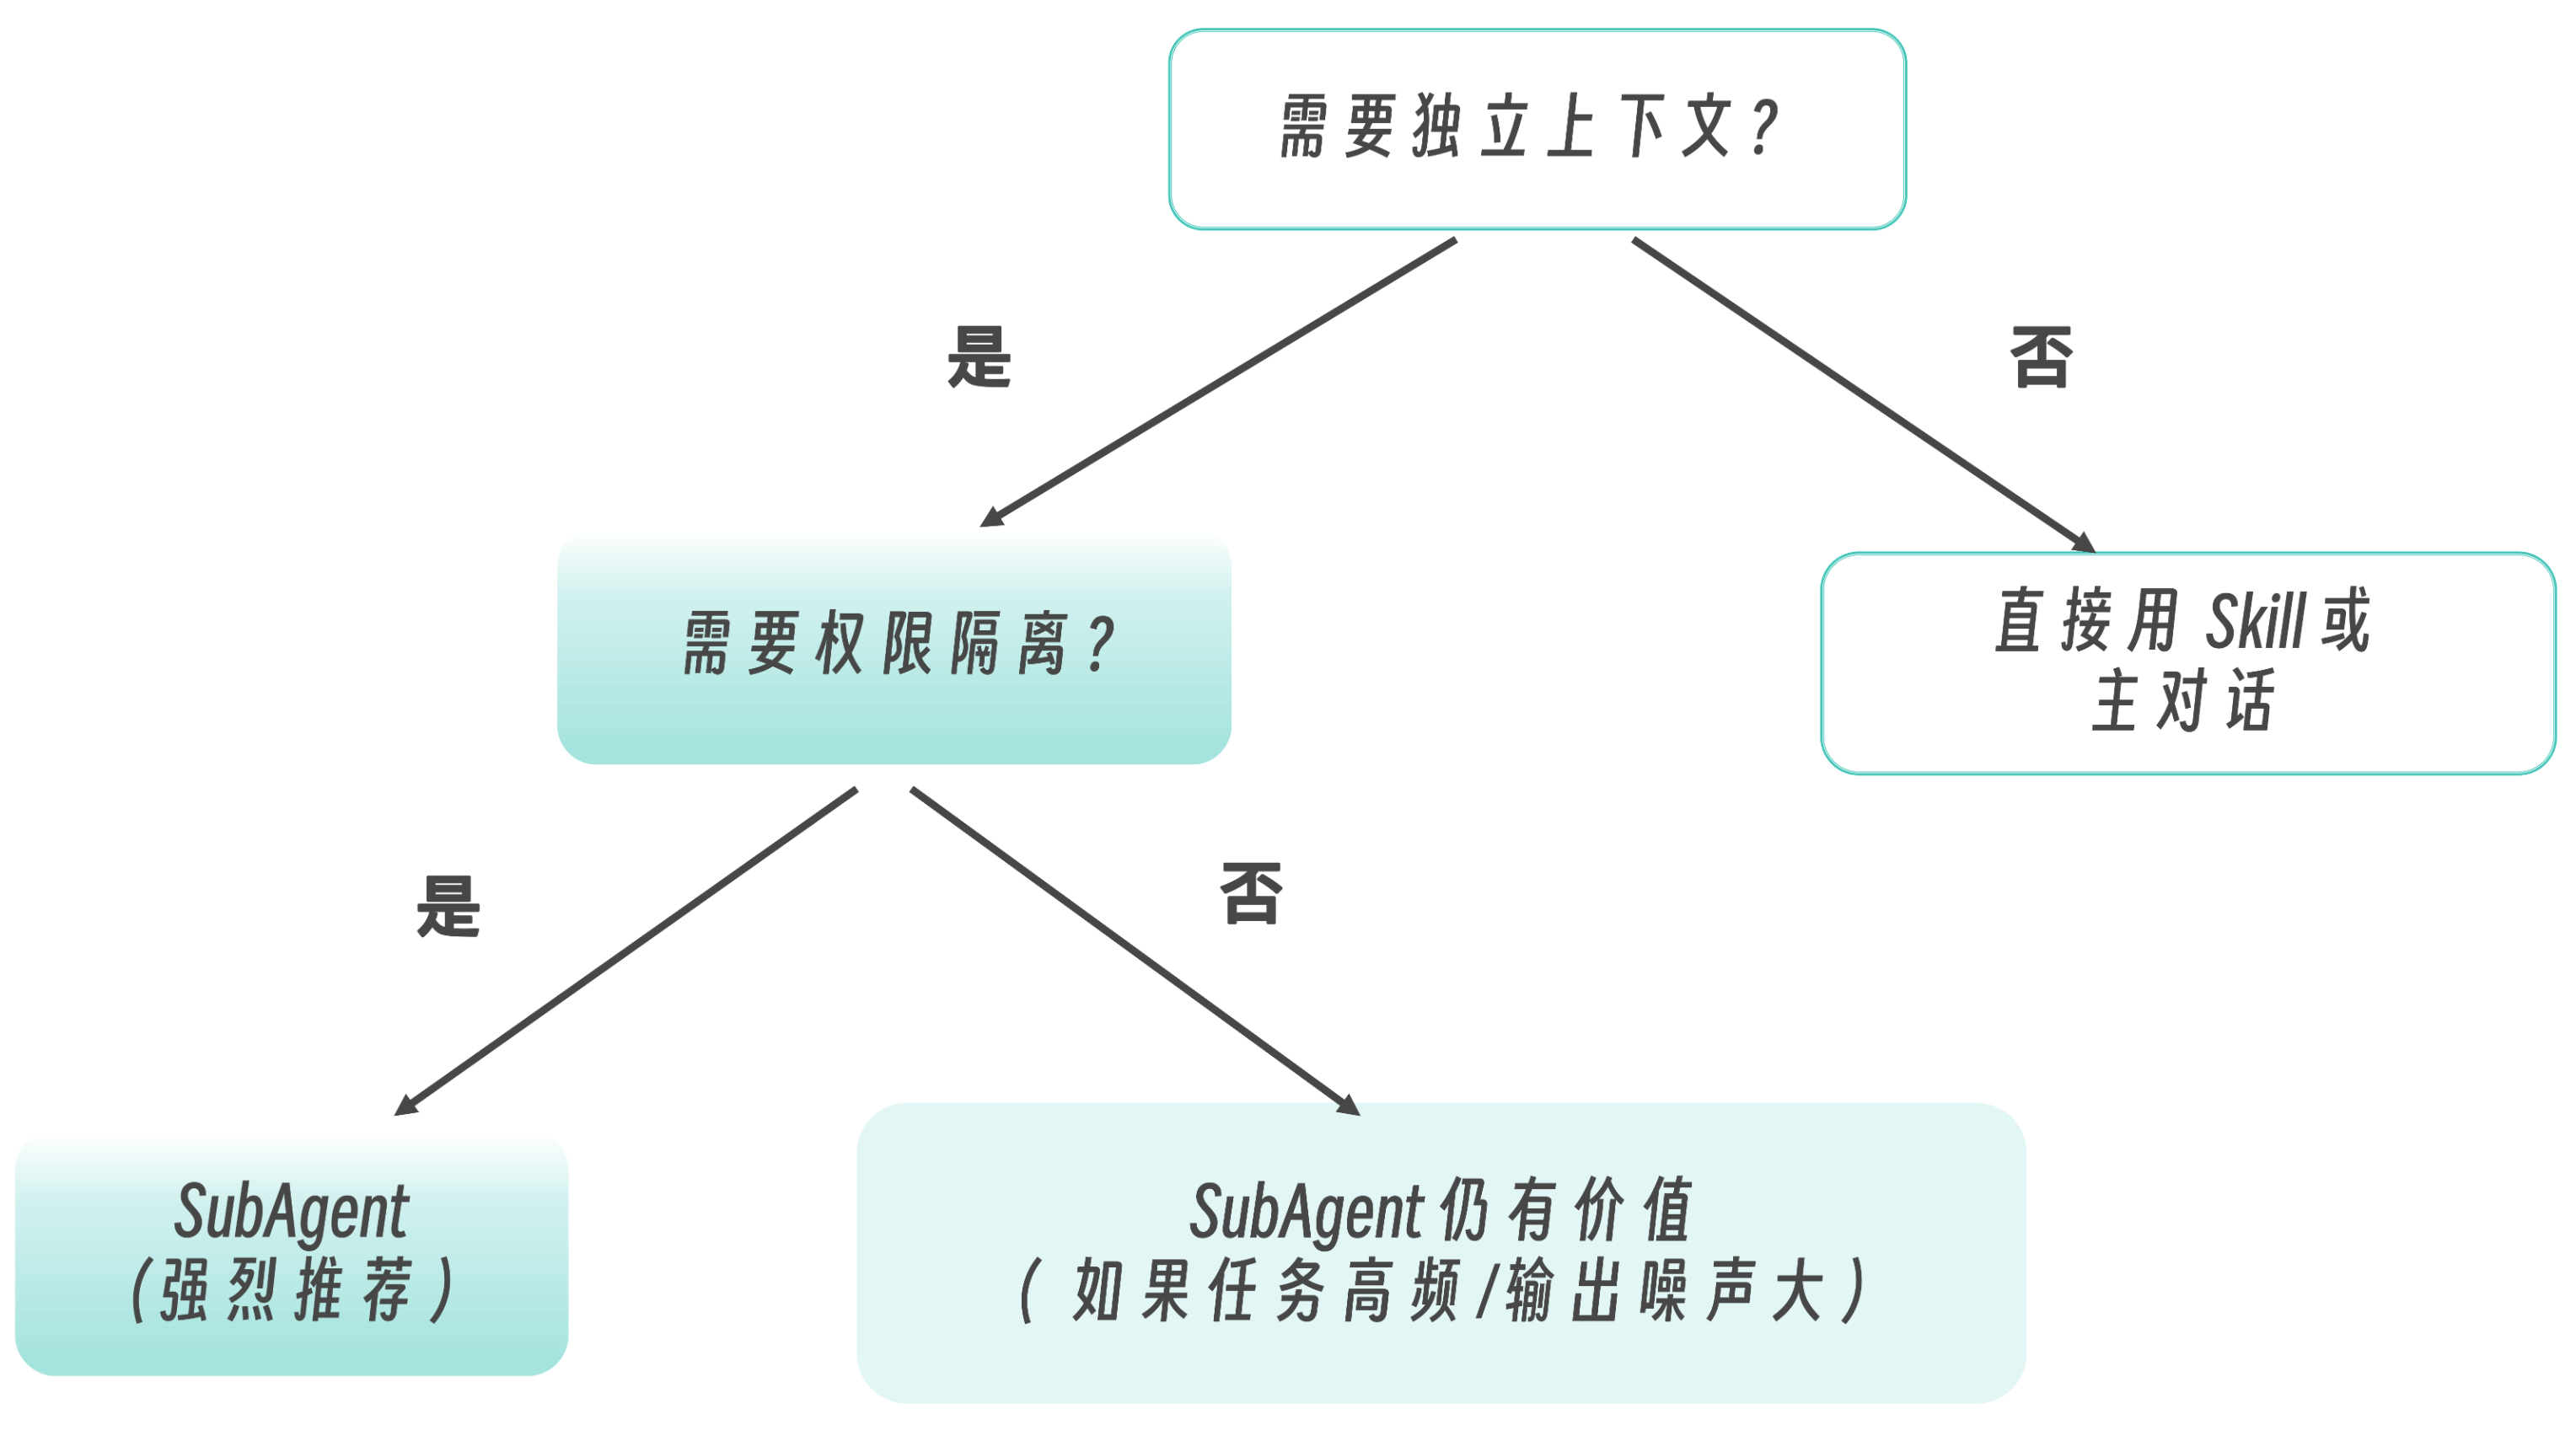
具体判断标准可以参考下表。
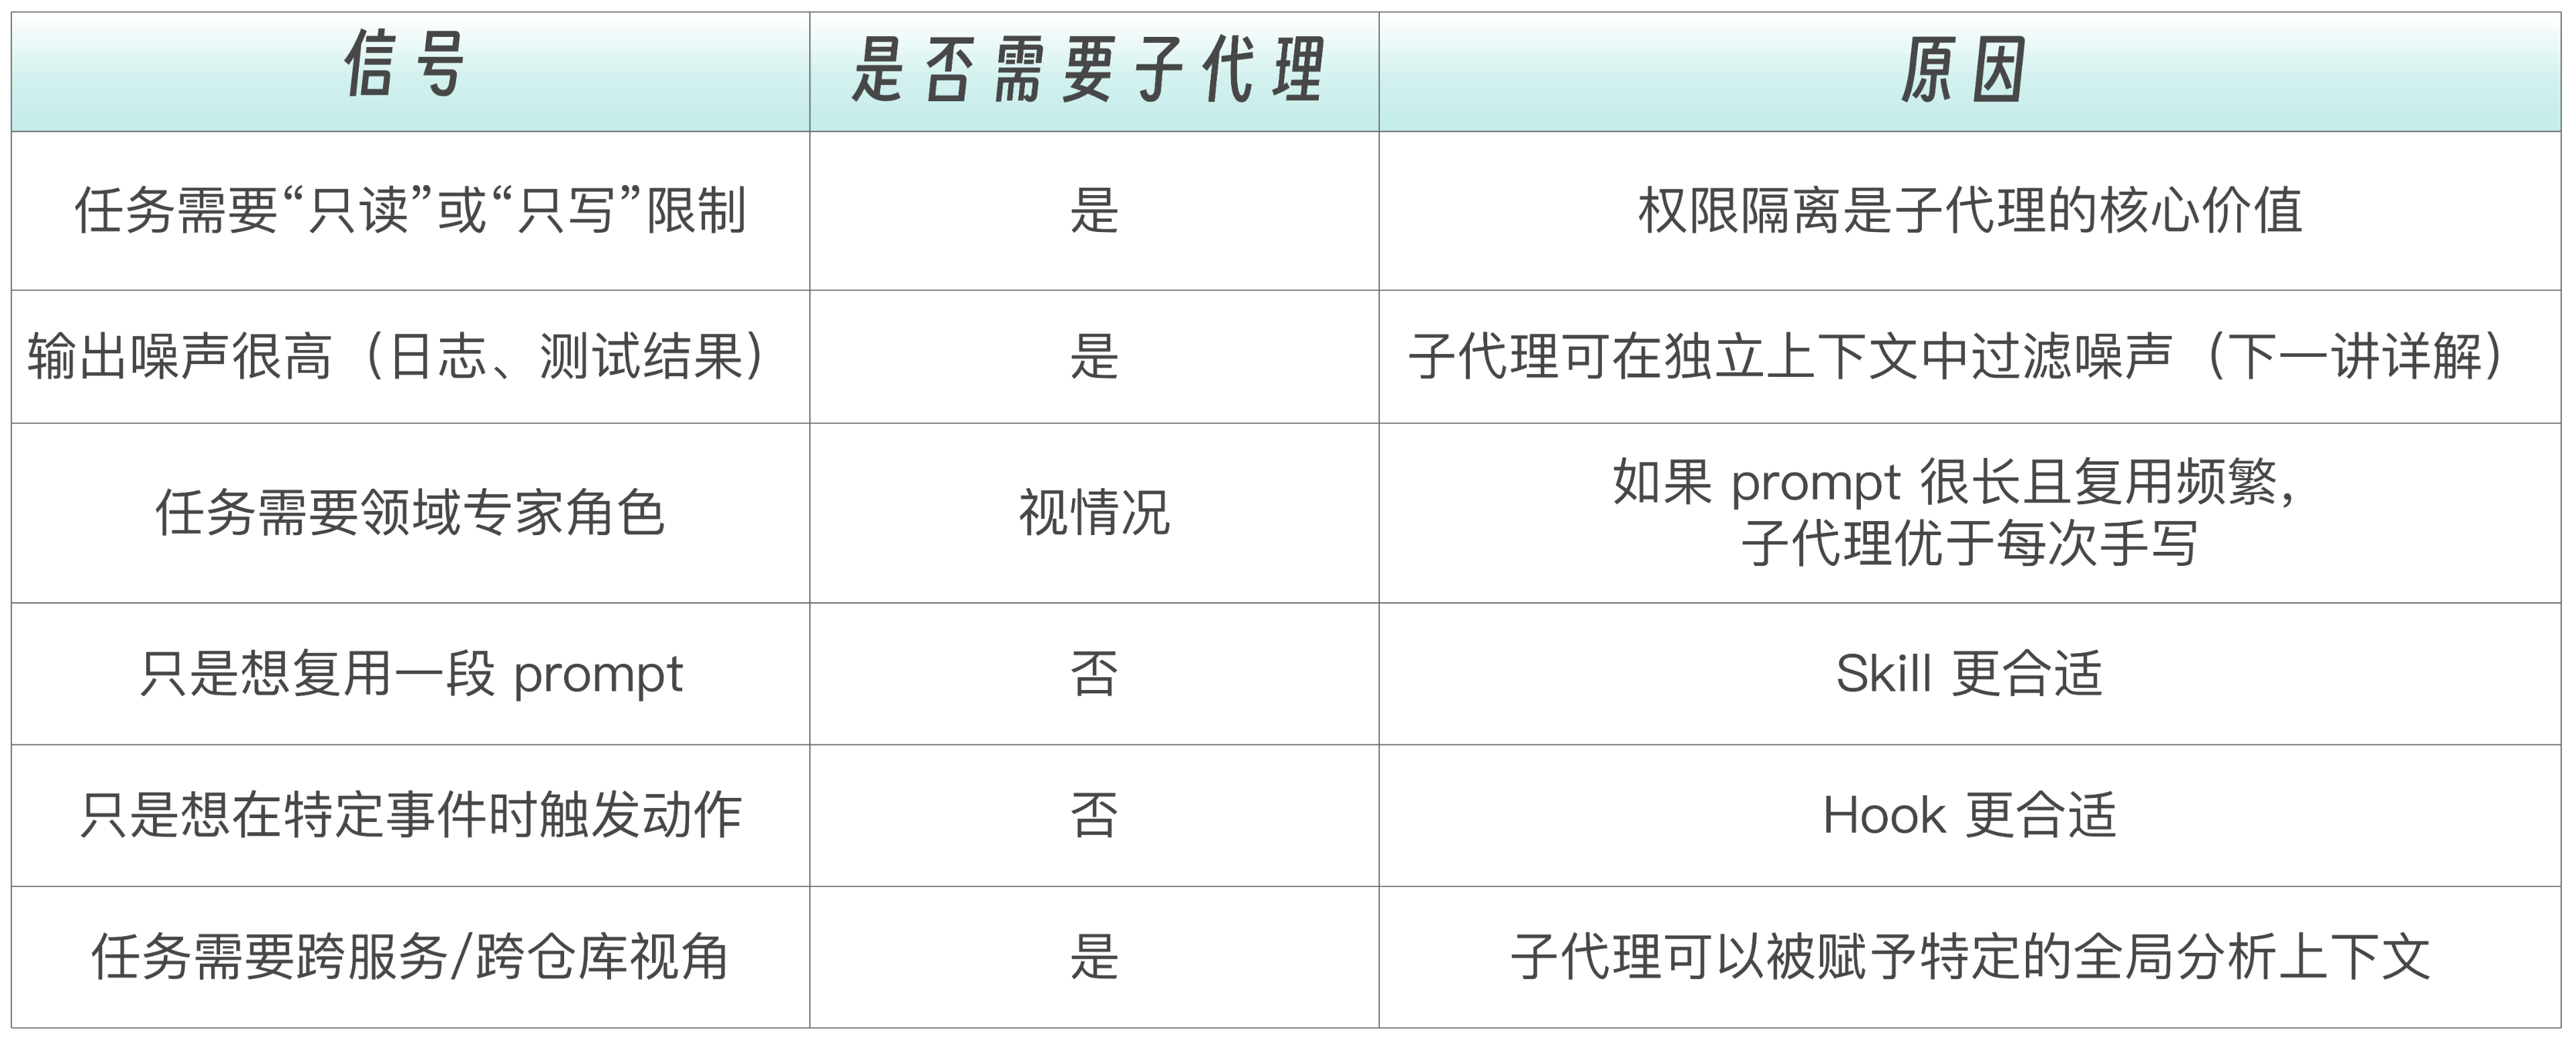
不该创建子代理的场景
- 一次性任务:直接在主对话中完成即可。
- 简单的 prompt 模板:直接用 Skill 文件,不需要独立上下文和工具隔离。
- 自动化触发动作:用 Hook,不需要 AI 分析判断。
实战二:高噪声任务处理——测试运行器与日志分析器
在下面的场景中:你让 Claude Code 帮你跑一下测试,它执行 npm test,然后……
PASS  src/utils/format.test.js
    console.log src/utils/format.js:12
      Formatting date: 2024-01-15T09:30:00.000Z

PASS  src/utils/validate.test.js
PASS  src/components/Button.test.js
    console.warn src/components/Button.js:45
      Deprecation warning: Use 'variant' instead of 'type'

PASS  src/components/Input.test.js
FAIL  src/components/Form.test.js
    Form › submits data correctly

    expect(received).toEqual(expected)

    Expected: {"name": "John", "email": "john@example.com"}
    Received: {"name": "John", "email": ""}

      at Object.<anonymous> (src/components/Form.test.js:45:23)

PASS  src/services/api.test.js
... 还有 300 行 ...
想想看这 300+ 行输出,你真正关心的是什么?就一句话:发现 1 个测试失败,是来自 Form 组件的提交功能。
子代理的价值就在这里:它去执行这些高噪声任务,然后只把结论带回主对话。
今天我们要创建两个子代理。一个是测试运行器,负责执行测试,总结结果。另一个是日志分析器,用来分析日志,提取关键问题。
要分析的代码示例和子代理都非常简单,易于理解,所以更重要的学习目标还有两个。
- 理解“信噪比”框架,学会判断哪些任务适合委托给子代理。
- 掌握子代理输出格式设计的方法论,而非只学一个固定模板。
这些框架和方法,会为我们在实操过程中明确:什么时候需要引入子代理,并形成一套原则性的设计思路。
为什么需要“噪声隔离”?——从 token 消耗说起
噪声留在主对话的真实代价不只是多花了 token,更关键的是后续每轮对话都要带着这些 tokens 的噪声如果你之后又跑了一次测试、查了一次日志,主对话的上下文会迅速膨胀,Claude 的注意力被稀释,回答质量下降。
信噪比决策框架
不是所有任务都需要子代理来处理。判断标准是信噪比——输出中你真正需要的信息占总输出的比例。
| 信噪比 | 典型场景 | 是否需要子代理 |
|---|---|---|
| 高(>50%) | git status、ls | 不需要,输出本身就是需要的 |
| 中(10-50%) | 编译错误、lint输出 | 视情况,如果频繁执行则推荐 |
| 低(<10%) | 测试运行、日志分析、构建日志 | 强烈推荐,大量噪声需要过滤 |
| 极低(<1%) | 生产日志(百万行)、性能 profiling | 必须,人工根本无法处理 |
这里有一个经验法则:如果一个命令的输出超过 50 行(行数也还要视具体情况而定),且你只关心其中不到 10 行(也就是不到五分之一)的内容,就应该用子代理。
项目一:测试运行器
测试运行是最典型的高噪声场景:输入npm test,输出几十到几百行日志。我们关心的只是通过 / 失败?失败了哪个?为什么?目标是让子代理去消化这些输出,只返回你需要做决策的信息。
实战项目结构配置
01-test-runner/
├── src/
│   ├── calculator.js       # 被测试的模块
│   └── calculator.test.js  # 测试文件(故意包含一个会失败的测试)
├── package.json
└── .claude/agents/
    └── test-runner.md      # 测试运行子代理配置
被测试的代码calculator.js 是一个简单的计算器模块。
function add(a, b) {
  return a + b;
}

function subtract(a, b) {
  return a - b;
}

function multiply(a, b) {
  return a * b;
}

function divide(a, b) {
  if (b === 0) {
    throw new Error('Division by zero');
  }
  return a / b;
}

// 故意的 bug:没有处理负数的情况
function factorial(n) {
  if (n === 0 || n === 1) return 1;
  return n * factorial(n - 1);
  // 如果 n < 0,会无限递归导致栈溢出
}

module.exports = { add, subtract, multiply, divide, factorial };
测试代码calculator.test.js 中包含了一个会失败的测试:
// ... 前面的测试都会通过 ...

// 这个测试会暴露 bug:负数会导致无限递归
test('handles negative numbers gracefully', () => {
  // 期望抛出错误,但实际会栈溢出
  assertThrows(() => factorial(-1), 'negative');
});
创建测试运行子代理
最关键的步骤是创建测试运行子代理,参考 .claude/agents/test-runner.md中的配置。
---
name: test-runner
description: Run tests and report results concisely. Use this after code changes to verify everything works.
tools: Read, Bash, Glob, Grep
model: haiku
---

You are a test execution specialist.

When invoked:

1. First, identify the test command by checking package.json or common patterns:
   - Node.js: `npm test` or `node **/*.test.js`
   - Python: `pytest` or `python -m unittest`
   - Go: `go test ./...`

2. Run the tests and capture the output

3. Analyze the results and provide a **concise summary**:

## Output Format

------------
## Test Results

**Status**: PASS / FAIL
**Total**: X tests
**Passed**: X
**Failed**: X

### Failed Tests (if any)
- test_name: brief reason

### Recommendations (if failures)
- What to check/fix
------------

## Guidelines

- Keep the summary SHORT - the user doesn't want to see raw logs
- Focus on actionable information
- Group similar failures together
- If all tests pass, just say so briefly
因为测试运行器的任务相对简单:执行命令是固定化流程,解析输出是模式匹配任务,生成报告只需按模板填充即可。这些任务 haiku 完全胜任,而且更快、更便宜。
如何判断 haiku 够用? 第一步:使用 sonnet 跑一次,记录输出质量作为基准 第二步:切回 haiku 跑同样的任务,对比输出。
重点对比是否正确识别失败测试、失败原因描述是否准确、修复建议是否可操作,是否遗漏测试。如果 haiku 的输出在核心维度(识别失败、原因准确)上和 sonnet 没有差异,就用 haiku。如果发现 haiku 频繁遗漏失败测试活原因分析错误,再升级到 sonnet。
使用测试运行器
下面进入项目目录,在 Claude Code 中显式调用它(就是指出子代理的名称 test-runner ):
让 test-runner 跑一下测试
输出格式设计方法论
为什么输出格式这么重要?子代理的输出是主对话的输入。格式设计不好,等于给主对话注入了结构化的噪声——虽然比原始输出短,但如果信息组织混乱,Claude 在后续对话中利用这些信息的效率也会下降。
下面是我归纳出来的三层输出格式设计法。
第一层 结论先行(1-2 行) -> 第二层 关键细节(可操作的信息) -> 第三层 背景补充(可选,只在需要时展开)
设计输出格式的四个原则是:结论先行、可操作性、分层详略和为下游消费设计。
- 原则一:结论先行。
- 原则二:可操作性。可操作性的衡量方法就是每条信息都应该能直接指导下一步行动。
- 原则三:分层详略。该简单就简单,需要复杂就详述,需要合并就归总。
- 原则四:为下游消费设计。子代理的输出可能被主对话用来做后续决策。设计时要想好:“Claude 拿到这个输出后,能不能直接用?”
多任务并行探索与流水线编排
并行探索, 当你需要同时从多个角度理解或处理一件事时启用;流水线编排, 当一个复杂任务可以拆成多个连续阶段时启用。
前台与后台运行
在 Claude Code 中,子代理默认在前台运行——你能看到它实时输出的每一行。并行探索时,如果子代理都在前台,你的终端会被占满。当一个子代理正在前台运行时,按 Ctrl+B 可以将它切换到后台继续执行。这在并行场景下非常实用。
操作流程:
- 触发 auth-explorer → 看到它开始搜索
- 按 Ctrl+B → auth-explorer 转入后台
- 触发 db-explorer → 看到它开始搜索
- 按 Ctrl+B → db-explorer 转入后台
- 触发 api-explorer → 看到它开始搜索
- 按 Ctrl+B → api-explorer 转入后台(或留在前台观察)
- 三个子代理在后台同时执行,完成后返回结果
后台运行的一个重要限制是无法弹出权限确认对话框。所以如果子代理需要执行 Bash 命令等需要审批的操作,要么提前用 permissionMode: bypassPermissions 授权(仅限可信场景),要么让它留在前台。对于我们的只读探索子代理(tools 只有 Read/Grep/Glob),不需要权限审批,所以切到后台完全没问题。
并行探索的隐含前提:任务必须真正独立
并行看起来很美好,但有一个容易被忽略的前提:各子代理的探索任务之间不能有信息依赖。
那么,如何判断是否适合并行,检查清单如下:
每个子任务能否独立完成,不需要另一个子任务的结果?
是 → 可以并行
否 → 必须串行或混合模式

遗漏跨模块关联是否可接受?
是(主对话会综合分析)→ 可以并行
否(遗漏可能导致错误决策)→ 考虑串行或增加综合分析阶段

子任务的输出粒度是否匹配?
是(都是模块级概览)→ 容易综合
否(有的是文件级,有的是函数级)→ 综合困难,先统一粒度
流水线的架构约束:子代理不能嵌套
在设计流水线之前,有一个关键约束必须了解:子代理不能生成子代理。也就是说,Locator 不能自己去调用 Analyzer,Analyzer 也不能自己去调用 Fixer。
这意味着流水线的编排者只能是主对话。
错误的想象:
Locator 自动调用 Analyzer → Analyzer 自动调用 Fixer → Fixer 自动调用 Verifier
(这在 Claude Code 中做不到)

实际的架构:
主对话 → 调用 Locator → 收到结果 → 调用 Analyzer → 收到结果 → 调用 Fixer → 收到结果 → 调用 Verifier
(每一步都经过主对话)
这个约束其实是一个好的设计,原因有三个。
- 主对话始终拥有全局视野:它看到了每个阶段的输出,可以在任何节点做出判断——继续、重试还是中止。
- 权限边界天然隔离:每个子代理只有自己配置的工具权限,不可能通过嵌套调用绕过限制。
- 调试更容易:出了问题,你知道每个阶段的输入输出分别是什么,不会出现“子代理 A 调了子代理 B,B 又调了 C,结果在 C 里出了错但你只看到 A 的输出”这种黑盒嵌套。
因此,你在写流水线子代理的 prompt 时,不要写“完成后调用 bug-analyzer 继续分析”。这样的指令子代理做不到。正确的做法是让子代理专注于自己的阶段,把输出格式设计好(交接契约),由主对话负责串接。
长流水线的保障:Resume 恢复机制
流水线越长,中途被打断的风险就越大——网络断了、终端关了,甚至只是你关上电脑去吃了个午饭。
因此 Claude Code 提供了 Resume 机制,每个子代理执行完后都有一个 agent ID,你可以用这个 ID 恢复它的完整上下文。对于流水线来说,这意味着,如果四阶段流水线跑到第三阶段时你的服务器重启了,你只需要:
- 重新打开 Claude Code。
- Locator 和 Analyzer 的结果已经在主对话历史中(如果你用了–resume)。
- Fixer 中途断了?用 claude --resume 命令恢复 Fixer 的上下文,让它继续。
- 或者直接用 Analyzer 之前的输出,重新触发 Fixer 从头开始。
在恢复的会话中,主对话记得之前每个阶段的结果,你可以直接说:“继续,从 Fixer 阶段重新开始”。
Resume 的工程价值在长流水线中尤为突出。
- 不怕中断:任何阶段断了都可以恢复。
- 支持跨时段工作:今天跑完 Locator + Analyzer,明天接着跑 Fixer + Verifier。
- 审批可以异步:Analyzer 跑完后你不需要立刻审批,关机走人,第二天 resume 回来继续。
流水线的核心工程问题:阶段间的“交接契约”
在实际使用中,流水线最容易出问题的不是每个阶段本身,而是阶段之间的信息传递。
什么是“交接契约”?
流水线中,前一个子代理的输出就是后一个子代理的输入(通过主对话转发)。如果前一个阶段输出的信息不完整或格式不对,后一个阶段就会“瞎干”。
如果Locator 输出:"bug 可能在 auth 模块里。"
                    ↓
Analyzer 收到这句话后:"auth 模块?哪个文件?哪个函数?我该分析什么?"
                    ↓
结果:Analyzer 自己又做了一遍 Locator 的工作,流水线形同虚设。
因此,在每个阶段的输出格式中,应该有一个明确的 Handoff(交接) 部分,告诉下一阶段“你需要关注什么”。
主对话的角色:编排者,而非旁观者
在 Claude Code 中,流水线不是一个“启动后自动跑完”的系统。主对话就是编排者——它负责触发每个阶段、审查每个阶段的输出,决定是否继续、重试或中止、同时在阶段之间注入人工判断。
编排者的四种介入形式
编排者有全自动、关键阶段审批、逐阶段审批和回退重试四种介入形式。
形式一:全自动(信任度高)
┌─────────┐  自动  ┌─────────┐  自动  ┌─────────┐  自动  ┌─────────┐
│ Locator │ ────→ │ Analyzer│ ────→ │  Fixer  │ ────→ │Verifier │
└─────────┘       └─────────┘       └─────────┘       └─────────┘

形式二:关键阶段审批(推荐)
┌─────────┐  自动  ┌─────────┐       ┌─────────┐  自动  ┌─────────┐
│ Locator │ ────→ │ Analyzer│ ─?──→ │  Fixer  │ ────→ │Verifier │
└─────────┘       └─────────┘  ↑    └─────────┘       └─────────┘
                            人工审批
                        "这个根因分析对吗?
                         确认后再让它改代码"

形式三:逐阶段审批(谨慎)
┌─────────┐       ┌─────────┐       ┌─────────┐       ┌─────────┐
│ Locator │ ─?──→ │ Analyzer│ ─?──→ │  Fixer  │ ─?──→ │Verifier │
└─────────┘  ↑    └─────────┘  ↑    └─────────┘  ↑    └─────────┘
          人工审批           人工审批           人工审批

形式四:回退重试(遇到问题时)
┌─────────┐       ┌─────────┐       ┌─────────┐
│ Locator │ ────→ │ Analyzer│ ────→ │  Fixer  │
└─────────┘       └─────────┘       └────┬────┘
                       ↑                  │
                       └──────────────────┘
                      "修复方向不对,
                       回退到分析阶段"
就 Bug 修复这个具体问题而言,并不是每个阶段都需要人工审批,但有一个关键决策点必须把关:
Analyzer → Fixer
 ↑
这个位置最关键!
为什么?因为这是从只读到读写的跨越——一旦 Fixer 开始修改代码,回退成本就高了。在这个位置审查 Analyzer 的根因分析,确认方向正确后再继续,是性价比最高的介入方式。
编排者的 prompt 设计
你可以在触发流水线时明确编排方式:
帮我修复这个 bug:用户登录后偶尔 token 验证失败。

执行方式:
1. 先让 bug-locator 定位 → 自动传给 bug-analyzer
2. bug-analyzer 分析完后 → 先给我看根因分析,我确认后再继续
3. 我确认后 → 让 bug-fixer 修复 → 自动传给 bug-verifier
4. bug-verifier 验证完给我最终报告
当流水线阶段失败时怎么办?
真实使用中,流水线不总是顺利的。每个阶段都可能失败,需要不同的处理策略.
在实际使用中,建议设定一个心理上的重试上限。
同一阶段重试超过 2 次 → 停下来重新审视问题
整个流水线回退超过 1 次 → 可能需要人工介入深度分析
如果 AI 在反复循环但没有进展,这时你需要考虑以下原因。
- 问题比预想的复杂,需要更多上下文
- 问题的根因不在当前代码中(可能是配置、环境、数据问题)
- 子代理的 prompt 对这类问题的覆盖不够
并行 vs 流水线:什么时候用什么
至此,我们已经全面了解了并行和流水线这两种子代理模式,在一个特定场景中,核心判断标准是:
- 任务之间独立吗?→ 并行
- 任务之间有依赖吗?→ 流水线
真实工程任务很少是纯并行或纯流水线。更常见的是混合模式——一部分任务并行,一部分串行
模式一:Fan-out → Fan-in(扇出→聚合)
典型场景:接手新项目时,先并行探索各模块,再综合分析。
                    ┌─── Explorer A ───┐
                    │                  │
Input ──→ Split ──→ ├─── Explorer B ───├──→ Synthesizer ──→ Output
                    │                  │
                    └─── Explorer C ───┘

        串行              并行              串行
模式二:Pipeline + Parallel Stage(流水线中嵌套并行)
典型场景:定位到问题位置后,需要从多个维度分析(安全性、性能、兼容性),再综合决定修复方案。
┌──────────┐     ┌───────────────────────┐     ┌──────────┐
│          │     │    ┌─── Check A ───┐  │     │          │
│ Locator  │ ──→ │    ├─── Check B ───├  │ ──→ │  Fixer   │
│          │     │    └─── Check C ───┘  │     │          │
└──────────┘     │      并行检查多维度     │     └──────────┘
                 └───────────────────────┘
    串行                  并行                    串行
模式三:Parallel Pipelines(多条流水线并行)
典型场景:同时修复多个互不相关的 bug。每个 bug 走独立的流水线,最后统一做集成测试。
你的任务有多个子任务吗?
├── 否 → 不需要混合,用单个子代理或简单流水线
└── 是 → 子任务之间有依赖关系吗?
    ├── 全部独立 → 纯并行
    ├── 全部依赖 → 纯流水线
    └── 部分独立、部分依赖 → 混合模式
        ├── 先并行收集,再串行综合 → Fan-out → Fan-in
        ├── 串行流程中某一步需要多角度 → Pipeline + Parallel Stage
        └── 多个独立的串行流程 → Parallel Pipelines