Service
Service 资源基础
-
Service是Kubernetes标准的API资源类型之一
-
为动态的Pod资源提供近似静态的流量入口
-
服务发现:通过标签选择器筛选同一名称空间下的Pod资源的标签,完成Pod筛选
- 实际上是由与Service同名的Endpoint或EndpointSlice资源及控制器完成
-
流量调度:由运行各工作节点的kube-proxy根据配置的模式生成相应的流量调度规则
- iptables
- ipvs
-
-
持续监视着相关Pod资源的变动,并实时反映至相应的流量调度规则之上
-
动态可配置负载均衡
-
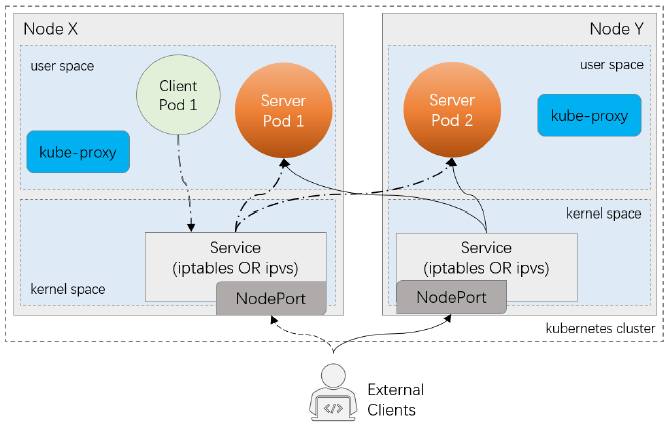
从Service的视角来看,Kubernetes集群的每个工作节点都是动态可配置的负载均衡器
-
对于隶属某Service的一组Pod资源,该Service资源能够将集群中的每个工作节点配置为该组Pod的负载均衡器
-
客户端可以是来自集群之上的Pod,也可以是集群外部的其它端点
-
对于一个特定的工作节点上的某Service来说,其客户端通常有两类
-
该节点之上的进程,可通过该Service的Cluster IP进入
- Service_IP:Service_Port
-
该节点之外的端点,可经由该Service的NodePort进入
- Node_IP:Node_Port
-
-
显然,若客户端进入的节点,并非目标Pod所在的节点时,报文转发的路径中必然存在跃点
Service 的4种类型
-
Service根据其所支持的客户端接入的方式,可以分为4种类型
-
ClusterIP:默认,它是K8S系统自动分配的虚拟IP,ClusterIP 类型会为 Service 创建一个 VIP,只能在集群内部访问;
-
NodePort:将Service通过指定的Node上的端口暴露给外部,通过此方法,就可以在集群外部访问服务;不过,由于这种暴露方式会侵入到节点,并且还需要配置的端口在节点上没有被占用,所以我并不推荐这种 Service 暴露方式,我们在实际工作中也一般不会使用这种方式。
-
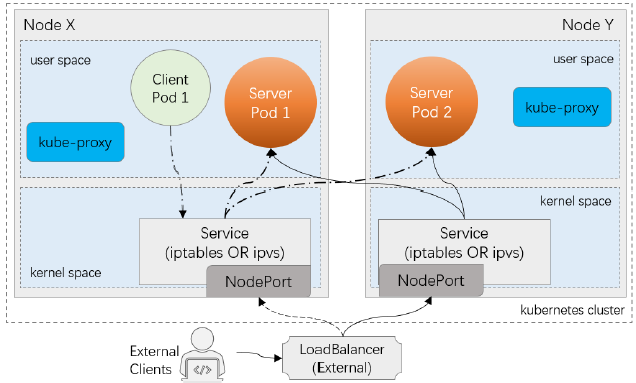
LoadBalancer:使用外接负载均衡器完成到服务的负载分发,注意此模式需要外部云环境支持;
-
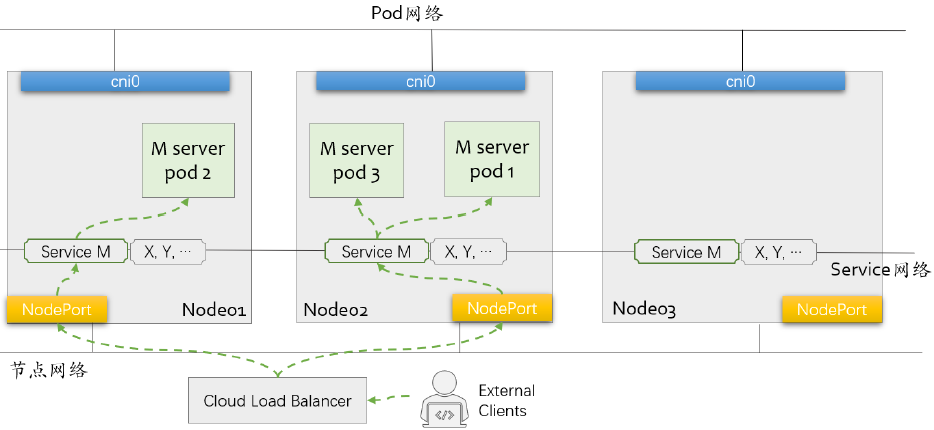
Kubernetes集群外部的LoadBalancer负责将接入的流量转发至工作节点上的NodePort
-
LoadBalancer需与相关的NodePort的Service生命周期联动
- LoadBalancer应该是由软件定义
- Kubernetes需要同LoadBalancer所属的管理API联动
-
对于业务服务,我不推荐你直接使用 Loadbalancer 来暴露服务。首先,因为 Loadbalancer 具备独立的 IP 地址,所以云厂商通常会按照“时长+流量”的方式计费,这会带来高昂的成本。其次,一个 K8s 集群内通常会有多个业务 Service 需要暴露,所以这种方式会开通多个负载均衡器实例,这是没有必要的。
-
在实际的业务中,我们通常会在集群内安装一个入口网关,例如 Ingress-nginx,它会自带一个 Loadbalancer 类型的 Service,然后由 Ingress-nginx 来统一接收外部请求,并将请求转发到集群内部。我们只需要配置域名或路径规则即可实现一个 Loadbalancer IP 暴露集群所有 Service 的效果。
-
-
ExternalName:把集群外部的服务引入到集群内部直接使用
- 负责将集群外部的服务引入到集群中
- 需要借助于ClusterDNS上的CNAME资源记录完成
- 特殊类型,无需ClusterIP和NodePort
- 无须定义标签选择器发现Pod对象
- ClusterIP、NodePort 和 Loadbalancer 类型都是通过 Pod 选择器将 Service 和 Pod 关联起来,然后将请求转发到对应的 Pod 中的。而 ExternalName 类型非常特殊,它不通过 Pod 选择器关联 Pod ,而是将 Service 和另外一个域名关联起来。下面是一个 ExternalName 类型的Service Manifest 的例子:
apiVersion: v1 kind: Service metadata: name: backend-service namespace: default spec: type: ExternalName externalName: backend-service.example.svc.cluster.local- 当将上面的 Service 应用到集群之后,在 default 命名空间下访问 http://backend-serivce:5000 时,请求将会被转发到 example 命名空间下的 backend-service。我们会发现虽然目标 Service 和请求发起方不在同一个命名空间下,但可以通过这种方法屏蔽它们在不同命名空间的调用差异,使得两个服务看起来像是在同一个命名空间下。
- 此外,当我们需要通过 Service 名称的方式请求外部服务时,例如请求在集群外的数据库服务,也可以使用这种方法。
-
创建Service资源
-
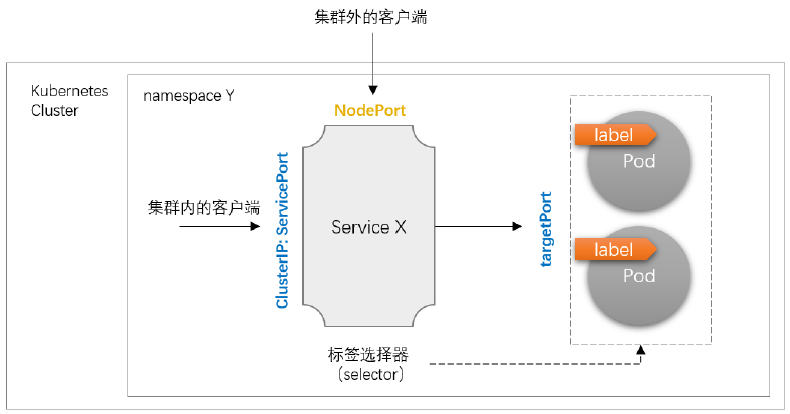
由Service表示的负载均衡器,主要定义如下内容
-
负载均衡器入口:ClusterIP及相关的Service Port、NodePort(每个节点的Node IP都可用)
- 根据通信需求,确定选择的类型
-
标签选择器:用于筛选Pod,并基于筛选出的Pod的IP生成后端端点列表(被调度的上游端点)
-
Service类型的专有配置
-
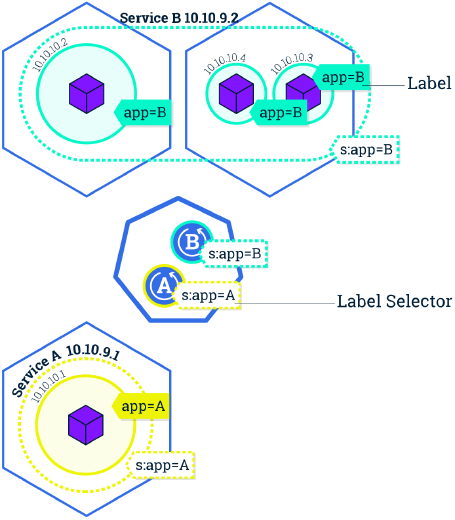
标签和标签选择器
-
标签:附加在资源对象上的键值型元数据
-
键标识:由“键前缀(可选)”和“键名”组成,格式为“key_prefix/key_name”
- 键前缀必须使用DNS域名格式
- 键名的命名格式:支持字母、数字、连接号、下划线和点号,且只能以字母或数字开头;最长63个字符;
-
“kubectl label”命令可管理对象的标签
-
-
标签选择器:基于标签筛选对象的过滤条件,支持两种类型
-
基于等值关系的选择器
- 操作符:=或==、!=
-
基于集合关系的选择器
- 操作符:in、notin和exists
- 使用格式:KEY in (VALUE1, VALUE2, …)、 KEY notin (VALUE1, VALUE2, …)、KEY 和 !KEY
-
Service资源规范
Kubernetes上标准的API资源类型
apiVersion: v1
kind: Service
metadata:
  name: <string>
  namespace: <string>
spec:
  type: <string>          # Service类型,默认为ClusterIP
  selector: <map[string]string>      # 等值类型的标签选择器,内含“与”逻辑
  ports:                  # Service的端口对象列表
  - name: <string>        # 端口名称
    protocol: <string>    # 协议,目前仅支持TCP、UDP和SCTP,默认为TCP
    port: <integer>       # Service的端口号
    targetPort: <string>  # 后端目标进程的端口号或名称,名称需由Pod规范定义
    nodePort: <integer>   # 节点端口号,仅适用于NodePort和LoadBalancer类型
  clusterIP: <string>     # Service的集群IP,建议由系统自动分配
  externalTrafficPolicy: <string>     # 外部流量策略处理方式,Local表示由当前节点处理,Cluster表示向集群范围调度
  loadBalancerIP: <string>      # 外部负载均衡器使用的IP地址,仅适用于LoadBalancer
  externalName: <string>         # 外部服务名称,该名称将作为Service的DNS CNAME值
Service资源示例
kind: Service
apiVersion: v1
metadata:
  name: demoapp
spec:
  type: ClusterIP     # 类型标识,默认即为ClusterIP;
  selector:
    app: demoapp
  ports:
  - name: http       # 端口名称标识
    protocol: TCP    # 协议,支持TCP、UDP和SCTP
    port: 80         # Service的端口号
    targetPort: 80   # 目标端口号,即后端端点提供服务的监听端口号
kind: Service
apiVersion: v1
metadata:
  name: demoapp
spec:
  type: NodePort     # 必须明确给出Service类型
  selector:
    app: demoapp
  ports:
  - name: http       # 端口名称标识
    protocol: TCP    # 协议,支持TCP、UDP和SCTP
    port: 80         # Service的端口号
    targetPort: 30080   # 可选,为避免冲突,建议由系统动态分配
EndPoint
从上面的信息中我们看到有个字段叫Endpoints,Endpoints 是Kubernetes中的一个资源对象,存储在etcd中,用来记录一个service对应的所有Pod的访问地址,它是根据service配置文件中的selector描述产生的。当我们在 Service 里使用 Pod 选择器时,我们并不需要主动去创建 Endpoints 对象。在创建 Service 之后,K8s 会自动帮助我们创建 Endpoint。
一个service由一组Pod组成,这些Pod通过Endpoints暴露出来,Endpoints是实现实际服务的端点集合。换言之,service和Pod之间的联系是通过Endpoints实现的。
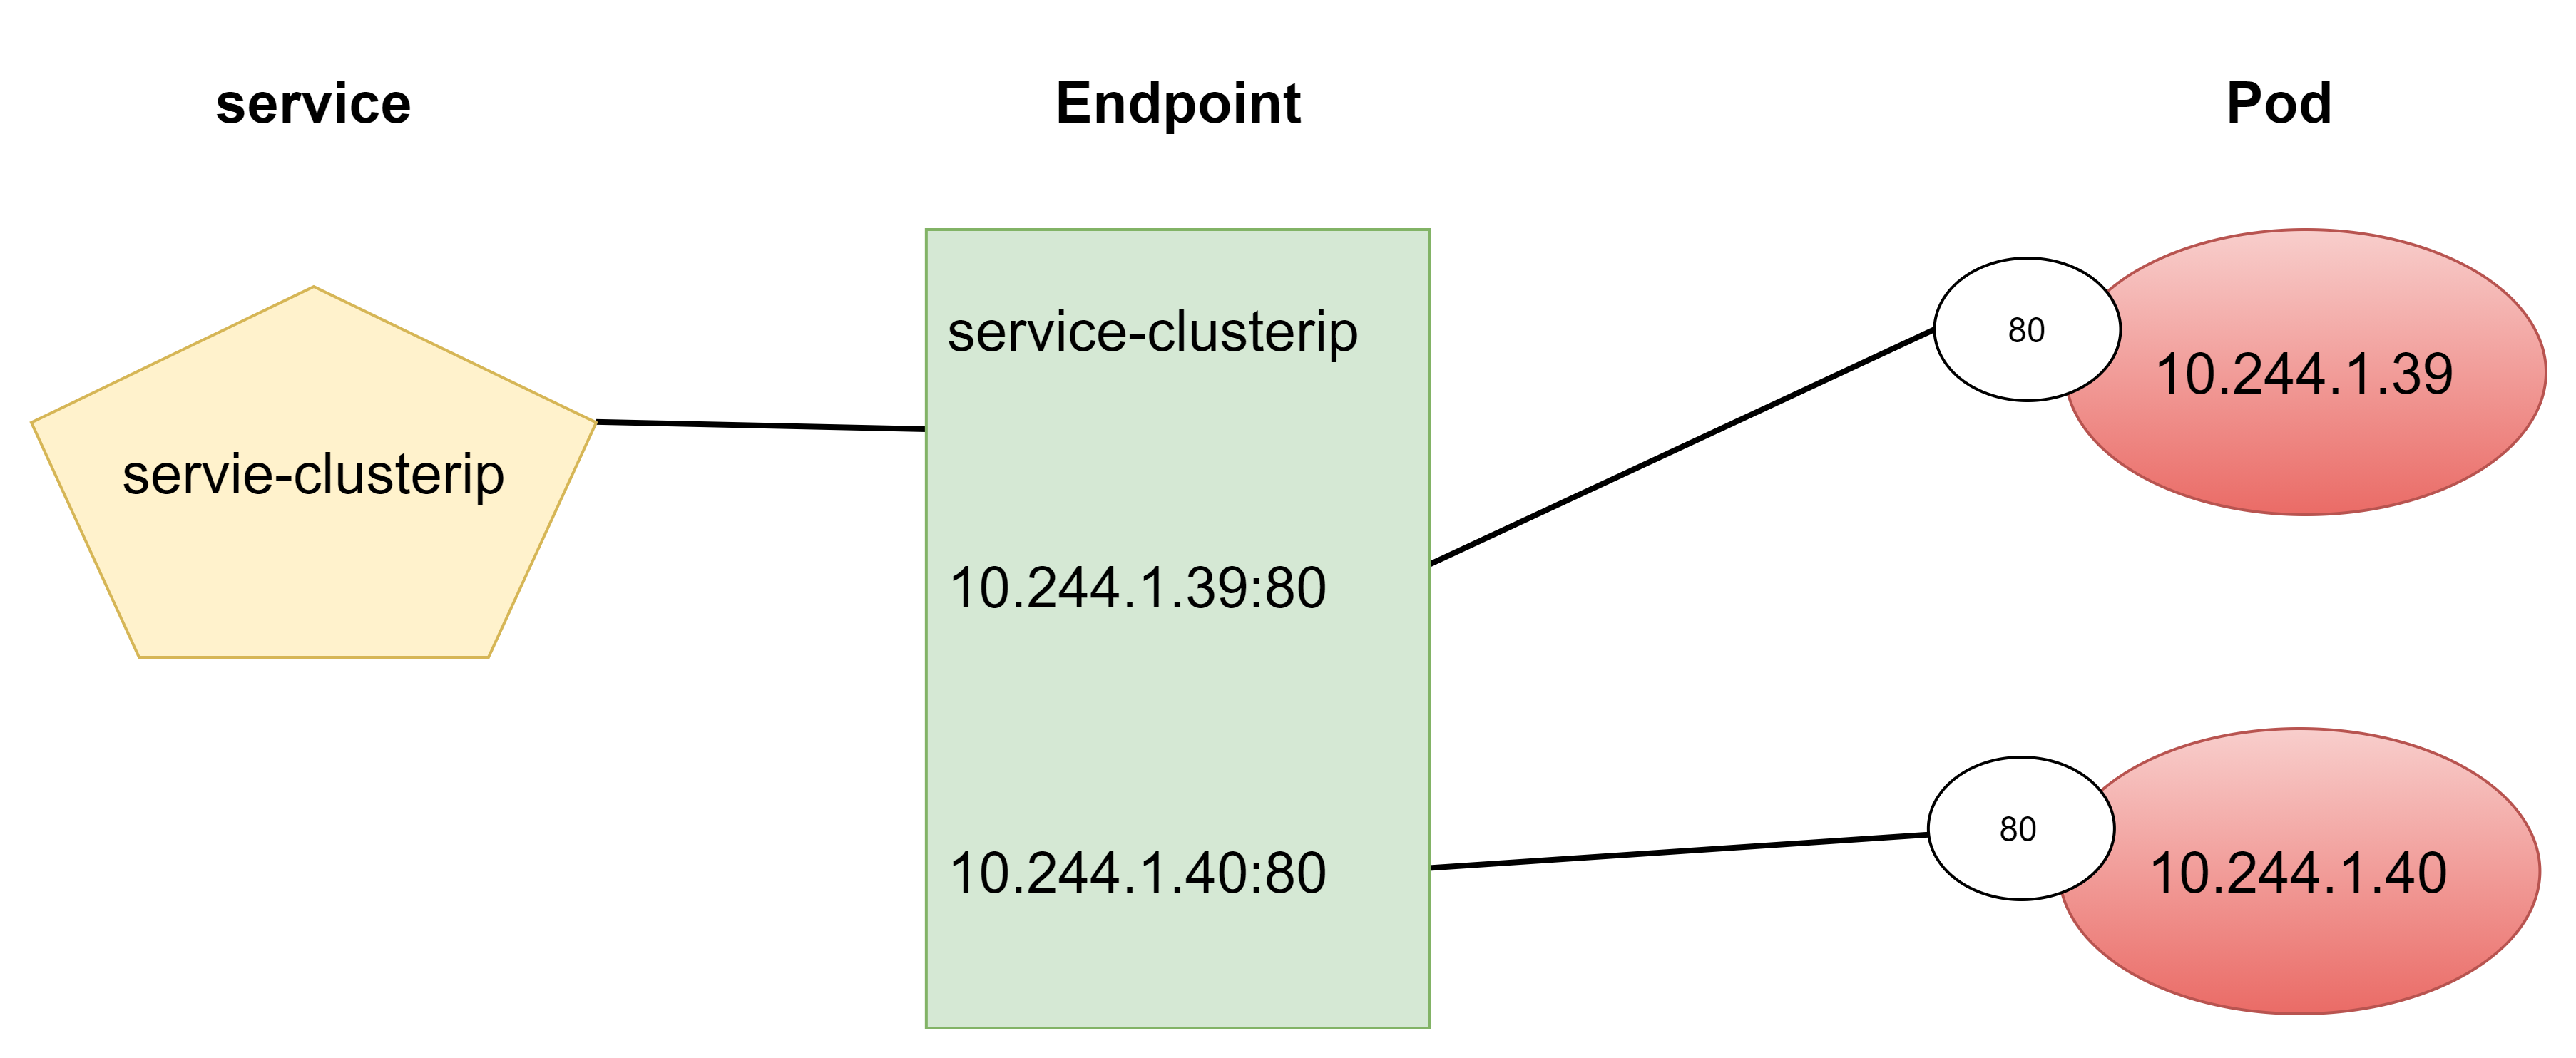
[root@master service]# kubectl get endpoints -n dev -o wide
NAME                ENDPOINTS                                        AGE
service-clusterip   10.244.1.120:80,10.244.1.121:80,10.244.2.45:80   5m7s
NodePort Service流量策略
-
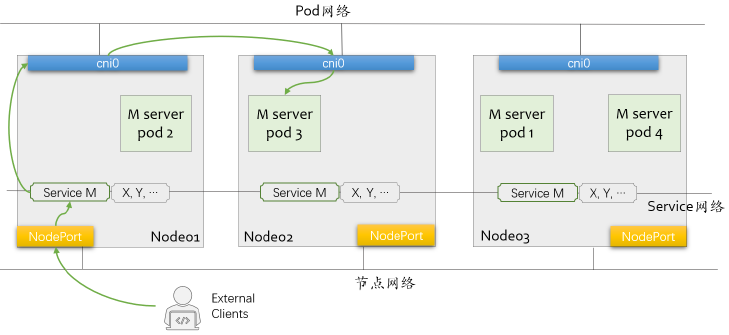
流量策略一:Cluster,表示在整个Kubernetes集群范围内调度;
- 该流量策略下,请求报文从某个节点上的NodePort进入,该节点上的Service会将其调度至任何一个可用后端Pod之上,而不关心Pod运行于哪个节点;
-
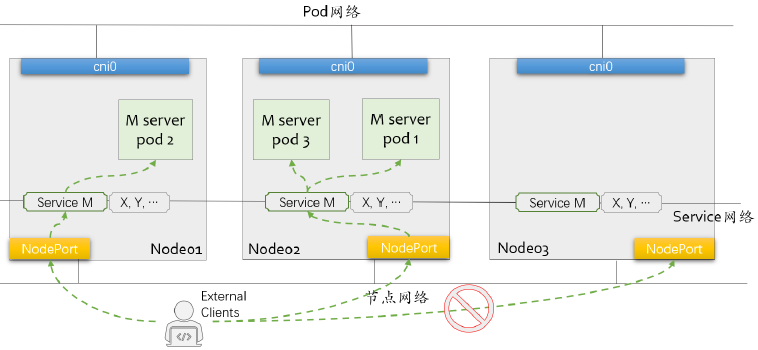
流量策略二:Local,表示仅将请求调度至当前节点上运行的可用后端端点;
- 该流量策略下,请求报文从某节点NodePort进入后,该节点上的Service仅会将请求调度至当前节点上适配到该Service的后端端点
- 仅应该从运行有目标Service对象后端Pod对象的节点的NodePort发起访问
LoadBalancer类型的Service
- 在接入外部流量方面,NodePort存在着几个方面的问题
- 非知名端口、私网IP地址、节点故障转移、节点间负载均衡、识别能适配到某Service的Local流量策略的节点等
- 外置的Cloud Load Balancer可以解决以上诸问题
Service和Cluster DNS
-
Cluster DNS(CoreDNS)是Kubernetes集群的必备附件,负责为Kubernetes提供名称解析和服务发现
-
每个Service资源对象,在CoreDNS上都会自动生成一个遵循
<service>.<ns>.svc.<zone>格式的名称- <service>:当前Service对象的名称
- <ns>:当前Service对象所属的名称空间
- <zone>:当前Kubernetes集群使用的域名后缀,默认为“cluster.local”
-
围绕该名称会生成一些DNS格式的资源记录
-
CoreDNS会持续监视API Server上的Service资源对象的变动,并实时反映到相关的DNS资源记录中
-
Pod中各容器默认会在/etc/resolv.conf中,将nameserver指向CoreDNS相关的Service的ClusterIP
-
由kubelet创建Pod时根据指定的配置自动注入
Service在Cluster DNS上的资源记录
-
每个Service,在CoreDNS上都会有A/AAAA、SRV和PTR资源记录
-
A/AAAA资源记录
- <service>.<ns>.svc.<zone>. <ttl> IN A <cluster-ip>
- <service>.<ns>.svc.<zone>. <ttl> IN AAAA <cluster-ip>
-
为每个定义了名称的端口生成一个SRV记录,以支持服务发现
- <port>.<proto>.<service>.<ns>.svc.<zone>. <ttl> IN SRV <weight> <priority> <port-number> <service>.<ns>.svc.<zone>.
-
为每个A记录(例如a.b.c.d)或AAAA记录生成对应的PTR记录,例如
- <d>.<c>.<b>.<a>.in-addr.arpa. <ttl> IN PTR <service>.<ns>.svc.<zone>.
- h4.h3.h2.h1.g4.g3.g2.g1.f4.f3.f2.f1.e4.e3.e2.e1.d4.d3.d2.d1.c4.c3.c2.c1.b4.b3.b2.b1.a4.a3.a2.a1.ip6.arpa <ttl> IN PTR <service>.<ns>.svc.<zone>.
-
-
Pod可基于Service的DNS名称向其发起服务访问请求
Pod上的DNS解析策略
-
Kubernetes支持在单个Pod资源规范上自定义DNS解析策略和配置,并组合生效
- spec.dnsPolicy:解析策略
- spec.dnsConfig:名称解析机制
-
DNS解析策略
- Default:从运行在的节点继承DNS名称解析相关的配置
- ClusterFirst:于集群DNS服务上解析集群域内的名称,其他域名的解析则交由从节点继承而来的上游名称服务器
- ClusterFirstWithHostNet:专用于在设置了hostNetwork的Pod对象上使用的ClusterFirst策略
- None:用于忽略Kubernetes集群的默认设定,而仅使用由dnsConfig自定义的配置
-
DNS解析机制
- nameservers <[]string>:DNS名称服务器列表,附加于由dnsPolicy生成的DNS名称服务器之后
- searches <[]string>:DNS名称解析时的搜索域,附加由于dnsPolicy生成的搜索域之后
- options <[]Object>:DNS解析选项列表,同dnsPolicy生成的解析选项合并成最终生效的定义
Headless Service
-
Service的各类型中,ClusterIP、NodePort和LoadBalancer都为其Service配置一个ClusterIP,CoreDNS上,这些Service对象的A记录也解析为它的ClusterIP;
-
广义上,那些没有 ClusterIP 的 Service 则称为 Headless Service,它们又可以为分两种情形
-
有标签选择器,或者没有标签选择器,但有着与Service对象同名的Endpoint资源
- Service的DNS名称直接解析为后端各就绪状态的Pod的IP地址
- 调度功能也将由DNS完成
- 各Pod IP相关PTR记录将解析至Pod自身的名称,假设Pod IP为a.b.c.d,则其名称为a-b-c-d.<service>.<ns>.svc.<zone>
- 这种类型也就是狭义上的Headless Service
-
无标签选择器且也没有与Service对象同名的Endpoint资源
- Service的DNS名称将会生成一条CNAME记录,对应值由Service对象上的spec.externalName字段指定
-
External Service示例
kind: Service
apiVersion: v1
metadata:
  name: externalname-mageedu
spec:
  type: ExternalName
  externalName: www.magedu.com
  ports:
  - protocol: TCP
    port: 80 target
    Port: 80
  selector: {}
Headless Service示例
kind: Service
apiVersion: v1
metadata:
  name: demoapp-headless-svc
spec:
  clusterIP: None
  selector:
    app: demoapp
  ports:
  - port: 80
    targetPort: 80
    name: http
Service流量转发机制
-
ClusterIP类型
-
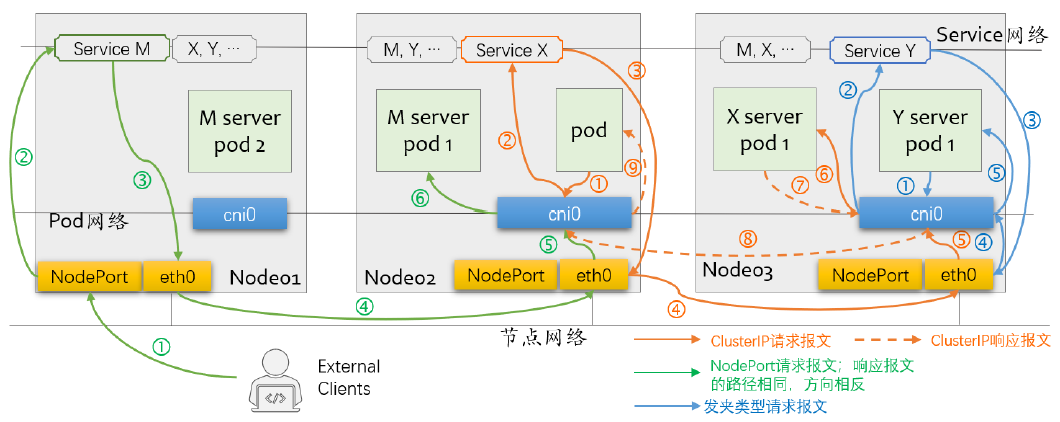
源自Pod
-
没启动masquerade-all:请求报文的目标IP和目标端口由Service转为挑选出的后端Pod的IP和端口,并由后端Pod直接响应给客户端Pod
- 发夹问题:Pod访问自身所属的Service后,由Service又调度回该Pod
- 存在发夹问题(haripin)的场景中,需要启用源IP地址转换
-
启用masquerade-all:请求报文的源IP和目标IP都将由Service进行转换,原IP将转为客户端Pod所在节点在Pod网络中的IP地址
-
-
源自非Pod网络中的请求流量
- 接入流量的节点充当NAT网关,请求报文的源IP和目标IP都将由Service进行转换
-
-
NodePort和LoadBalancer类型
- 流量来自集群外部,节点扮演网关的角色,请求报文的源IP和目标IP都将由Service进行转换,原IP将转为客户端Pod所在节点的IP地址,以确保响应报文能正确送达
-
流量转发示意图:请求报文,目标地址转换都会进行,未启用masquerade-all时,源地址转换将视情况进行
- Pod网络是虚拟网络,最终还是要通过节点网络完成报文传送,因此,SNAT通常会使用节点网络中的地址
你也可以再尝试一下使用“ping”来测试Service的IP地址:
会发现根本ping不通,因为Service的IP地址是“虚”的,只用于转发流量,所以ping无法得到回应数据包,也就失败了。(测试发下能ping 通?
如何以域名的方式使用Service
DNS是一种层次结构,为了避免太多的域名导致冲突,Kubernetes就把名字空间作为域名的一部分,减少了重名的可能性。
Service对象的域名完全形式是“ **对象.命名空间.svc.cluster.local**”,但很多时候也可以省略后面的部分,直接写“ **对象.名字空间**”甚至“ **对象名**”就足够了,默认会使用对象所在的名字空间。
(顺便说一下,Kubernetes也为每个Pod分配了域名,形式是“ **IP地址.名字空间.pod.cluster.local**”,但需要把IP地址里的 . 改成 - 。比如地址 10.10.1.87,它对应的域名就是 10-10-1-87.default.pod。)
Statefulset 的 Service
Service发现这些Pod不是一般的应用,而是有状态应用,需要有稳定的网络标识,所以就会为Pod再多创建出一个新的域名,格式是“ **Pod名.服务名.命名空间.svc.cluster.local**”。当然,这个域名也可以简写成“ **Pod名.服务名**”。
我们还是用 kubectl exec 进入Pod内部,用ping命令来验证一下:
kubectl exec -it redis-sts-0 -- sh
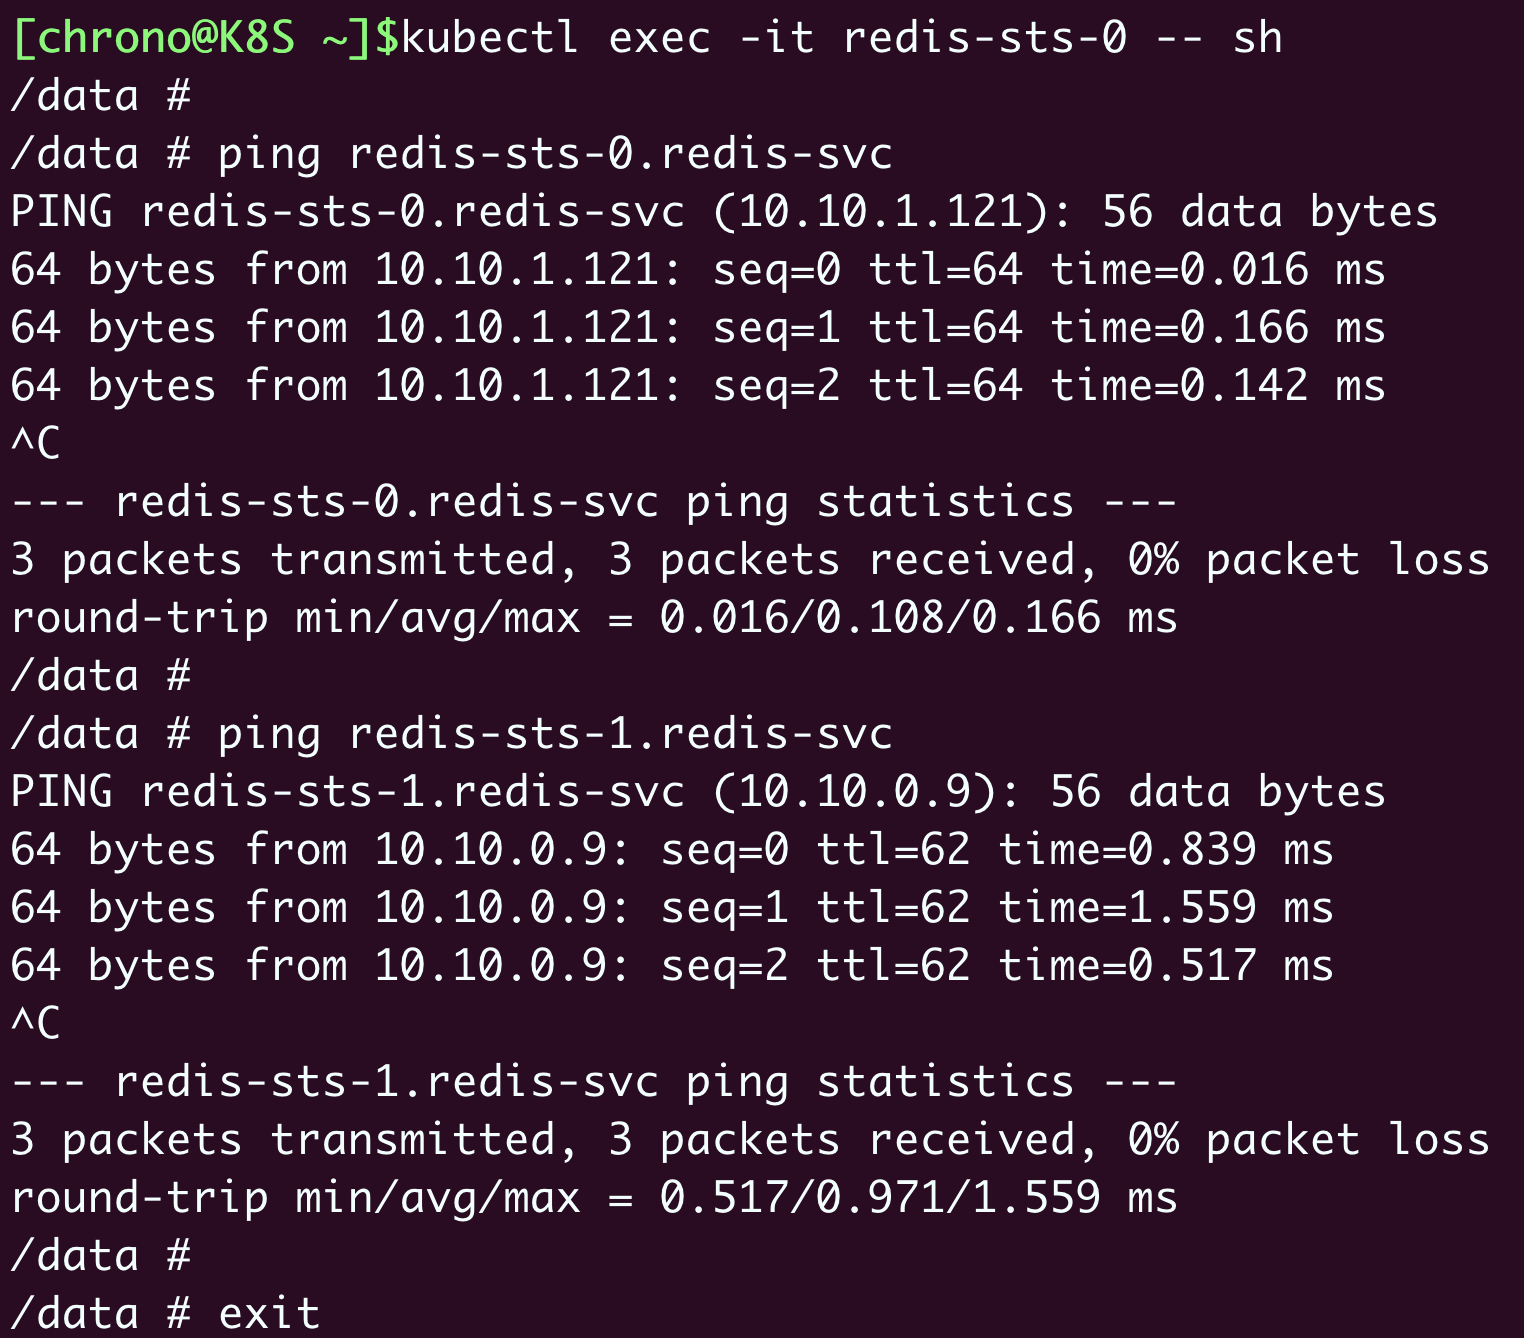
显然,在StatefulSet里的这两个Pod都有了各自的域名,也就是稳定的网络标识。那么接下来,外部的客户端只要知道了StatefulSet对象,就可以用固定的编号去访问某个具体的实例了,虽然Pod的IP地址可能会变,但这个有编号的域名由Service对象维护,是稳定不变的。
到这里,通过StatefulSet和Service的联合使用,Kubernetes就解决了“有状态应用”的依赖关系、启动顺序和网络标识这三个问题,剩下的多实例之间内部沟通协调等事情就需要应用自己去想办法处理了。
关于Service,有一点值得再多提一下。
Service原本的目的是负载均衡,应该由它在Pod前面来转发流量,但是对StatefulSet来说,这项功能反而是不必要的,因为Pod已经有了稳定的域名,外界访问服务就不应该再通过Service这一层了。所以,从安全和节约系统资源的角度考虑, **我们可以在Service里添加一个字段 ****clusterIP: None**** ,告诉Kubernetes不必再为这个对象分配IP地址**。