Python 代码规范(PEP8 规范)
Python 代码规范(PEP8 规范)
编码
- 如无特殊情况, 文件一律使用 UTF-8 编码
- 如无特殊情况, 文件头部必须加入
#-*-coding:utf-8-*-标识
# coding:utf-8    //脚本头
import os    //引用部分

print(os.getcwd())    //业务部分
print('Hello World!')
代码格式
缩进
- 统一使用 4 个空格进行缩进
行宽
每行代码不应超过 79 个字符(在特殊情况下可以略微超过 80 ,但最长不得超过 120)
理由:
- 这在查看 side-by-side 的 diff 时很有帮助
- 方便在控制台下查看代码
- 太长可能是设计有缺陷
引号
简单说,自然语言使用双引号,机器标示使用单引号,因此 代码里 多数应该使用 单引号
- 自然语言 使用双引号
"..."例如错误信息;很多情况还是 unicode,使用u"你好世界" - 机器标识 使用单引号
'...'例如 dict 里的 key - 正则表达式 使用原生的双引号
r"..." - 文档字符串 (docstring) 使用三个双引号
"""......"""
空行
- 模块级函数和类定义之间空两行;
- 类成员函数之间空一行;
class A:

    def __init__(self):
        pass

    def hello(self):
        pass

def main():
    pass
- 可以使用多个空行分隔多组相关的函数
- 函数中可以使用空行分隔出逻辑相关的代码
命名规范
变量名小写字母开头,下划线分割多个单词;类名大写字母开头,驼峰命名法.
模块
模块尽量使用小写命名,首字母保持小写,尽量不要用下划线(除非多个单词,且数量不多的情况)
# 正确的模块名
import decoder
import html_parser

# 不推荐的模块名
import Decoder
类名
- 类名使用驼峰(CamelCase)命名风格,首字母大写,私有类可用一个下划线开头
class Farm():
    pass

class AnimalFarm(Farm):
    pass

class _PrivateFarm(Farm):
    pass
- 将相关的类和顶级函数放在同一个模块里。
函数
- 函数名一律小写,如有多个单词,用下划线隔开
def run():
    pass

def run_with_env():
    pass
- 私有函数在函数前加一个下划线_
class Person():

    def _private_func():
        pass
变量
- 变量名尽量小写, 如有多个单词,用下划线隔开
if __name__ == '__main__':
    count = 0
    school_name = ''
- 常量采用全大写,如有多个单词,使用下划线隔开
MAX_CLIENT = 100
MAX_CONNECTION = 1000
CONNECTION_TIMEOUT = 600
常量
- 常量使用以下划线分隔的大写命名
MAX_OVERFLOW = 100

Class FooBar:

    def foo_bar(self, print_):
        print(print_)
注释
注释应该清晰简洁,使用英文书写。说明代码的作用而不是如何实现.
块注释
“#”号后空一格,段落件用空行分开(同样需要“#”号)
# 块注释
# 块注释
#
# 块注释
# 块注释
行注释
至少使用两个空格和语句分开,注意不要使用无意义的注释
# 正确的写法
x = x + 1  # 边框加粗一个像素

# 不推荐的写法(无意义的注释)
x = x + 1 # x加1
建议
- 在代码的关键部分(或比较复杂的地方), 能写注释的要尽量写注释
- 比较重要的注释段, 使用多个等号隔开, 可以更加醒目, 突出重要性
app = create_app(name, options)


# =====================================
# 请勿在此处添加 get post等app路由行为 !!!
# =====================================

if __name__ == '__main__':
    app.run()
括号
函数调用和定义中,括号内部应该没有空格
import 语句
- import 语句应该分行书写,写在使用之前,每个导入应该单独成行,避免使用通配符
# 正确的写法
import os
import sys

# 不推荐的写法
import sys,os

# 正确的写法
from subprocess import Popen, PIPE
- import语句应该使用 absolute import
# 正确的写法
from foo.bar import Bar

# 不推荐的写法
from ..bar import Bar
- import 语句应该放在文件头部,置于模块说明及 docstring 之后,于全局变量之前;
- import 语句应该按照顺序排列,每组之间用一个空行分隔
import os
import sys

import msgpack
import zmq

import foo
- 导入其他模块的类定义时,可以使用相对导入
from myclass import MyClass
- 如果发生命名冲突,则可使用命名空间
import bar
import foo.bar

bar.Bar()
foo.bar.Bar()
空格
运算符两侧、逗号后以及冒号后应添加空格
- 在二元运算符两边各空一格
[=,-,+=,==,>,in,is not, and]:
# 正确的写法
i = i + 1
submitted += 1
x = x * 2 - 1
hypot2 = x * x + y * y
c = (a + b) * (a - b)

# 不推荐的写法
i=i+1
submitted +=1
x = x*2 - 1
hypot2 = x*x + y*y
c = (a+b) * (a-b)
- 函数的参数列表中,
,之后要有空格
# 正确的写法
def complex(real, imag):
    pass

# 不推荐的写法
def complex(real,imag):
    pass
- 函数的参数列表中,默认值等号两边不要添加空格
# 正确的写法
def complex(real, imag=0.0):
    pass

# 不推荐的写法
def complex(real, imag = 0.0):
    pass
- 左括号之后,右括号之前不要加多余的空格
# 正确的写法
spam(ham[1], {eggs: 2})

# 不推荐的写法
spam( ham[1], { eggs : 2 } )
- 字典对象的左括号之前不要多余的空格
# 正确的写法
dict['key'] = list[index]

# 不推荐的写法
dict ['key'] = list [index]
- 不要为对齐赋值语句而使用的额外空格
# 正确的写法
x = 1
y = 2
long_variable = 3

# 不推荐的写法
x             = 1
y             = 2
long_variable = 3
换行
Python 支持括号内的换行。这时有两种情况。
- 第二行缩进到括号的起始处
foo = long_function_name(var_one, var_two,
                         var_three, var_four)
- 第二行缩进 4 个空格,适用于起始括号就换行的情形
def long_function_name(
        var_one, var_two, var_three,
        var_four):
    print(var_one)
使用反斜杠\换行,二元运算符+ .等应出现在行末;长字符串也可以用此法换行
session.query(MyTable).\
        filter_by(id=1).\
        one()

print 'Hello, '\
      '%s %s!' %\
      ('Harry', 'Potter')
禁止复合语句,即一行中包含多个语句:
# 正确的写法
do_first()
do_second()
do_third()

# 不推荐的写法
do_first();do_second();do_third();
if/for/while一定要换行:
# 正确的写法
if foo == 'blah':
    do_blah_thing()

# 不推荐的写法
if foo == 'blah': do_blash_thing()
函数和类:函数和类之间应该用两个空行分隔
文档注释 docstring
作为文档的Docstring一般出现在模块头部、函数和类的头部,这样在python中可以通过对象的__doc__对象获取文档. 编辑器和IDE也可以根据Docstring给出自动提示.
docstring 的规范中最基本的两点:
- 所有的公共模块、函数、类、方法,都应该写 docstring 。私有方法不一定需要,但应该在 def 后提供一个块注释来说明。
- docstring 的结束”””应该独占一行,除非此 docstring 只有一行。
"""Return a foobar
Optional plotz says to frobnicate the bizbaz first.
"""

"""Oneline docstring"""
文档注释以 """ 开头和结尾, 首行不换行, 如有多行, 末行必需换行, 以下是Google的docstring风格示例
# -*- coding: utf-8 -*-
"""Example docstrings.

This module demonstrates documentation as specified by the `Google Python
Style Guide`_. Docstrings may extend over multiple lines. Sections are created
with a section header and a colon followed by a block of indented text.

Example:
    Examples can be given using either the ``Example`` or ``Examples``
    sections. Sections support any reStructuredText formatting, including
    literal blocks::

        $ python example_google.py

Section breaks are created by resuming unindented text. Section breaks
are also implicitly created anytime a new section starts.
"""
- 不要在文档注释复制函数定义原型, 而是具体描述其具体内容, 解释具体参数和返回值等
#  不推荐的写法(不要写函数原型等废话)
def function(a, b):
    """function(a, b) -> list"""
    ... ...


#  正确的写法
def function(a, b):
    """计算并返回a到b范围内数据的平均值"""
    ... ...
- 对函数参数、返回值等的说明采用numpy标准, 如下所示
def func(arg1, arg2):
    """在这里写函数的一句话总结(如: 计算平均值).

    这里是具体描述.

    参数
    ----------
    arg1 : int
        arg1的具体描述
    arg2 : int
        arg2的具体描述

    返回值
    -------
    int
        返回值的具体描述

    参看
    --------
    otherfunc : 其它关联函数等...

    示例
    --------
    示例使用doctest格式, 在`>>>`后的代码可以被文档测试工具作为测试用例自动运行

    >>> a=[1,2,3]
    >>> print [x + 3 for x in a]
    [4, 5, 6]
    """
- 文档注释不限于中英文, 但不要中英文混用
- 文档注释不是越长越好, 通常一两句话能把情况说清楚即可
- 模块、公有类、公有方法, 能写文档注释的, 应该尽量写文档注释
基本数据类型
字符串
字符串英文 string ,是 python 中随处可见的数据类型,字符串的识别也非常的简单,就是用引号括起来的。
引号包括单引号 ' ' ,双引号 " " 和 三引号 ''' ''' 。
这里请注意,单引号 '' 或双引号 "" 本身只是一种表示方式,不是字符串的一部分,因此,字符串 'abc' 只有 a,b,c 这 3 个字符。
那么我们先来看下这三种方式,来定义同样内容的字符串。
str1 = '柯提'
str1 = "柯提"
str1 = '''柯提'''
字符串的基本操作
| x in s | 如果 s 中的某项等于 x,那么结果为 True,否则为 False |
|---|---|
| x not in s | 如果 s 中的某项等于 x,那么结果为 False,否则为 True |
| s + t | s 与 t 相拼接 |
| s * n 或 n * s | 相当于 s 与自身进行 n 次拼接 |
| s[i] | s 的第 i 项,起始为 0,-1 为最后一个字符 |
| s[i:j] | s 从 i 到 j 的切片 |
| s[i:j:k] | s 从 i 到 j 步长为 k 的切片 |
字符串的常用方法
字符串所有方法: https://docs.python.org/zh-cn/3.10/library/stdtypes.html#string-methods
join 将序列中的元素以指定的字符连接生成一个新的字符串。
str = ",".join("abcdefg")
print(str)

//输出
'a,b,c,d,e,f,g'
split 在指定的分隔符处分解一个字符串,并返回一个字符串列表。
返回一个由字符串内单词组成的列表。使用 , 作为分隔字符串
"a,b,c,d".split(",")

//输出
['a', 'b', 'c', 'd']
startswith
如果字符串以指定的 prefix 开始,那么返回 True,否则返回 False。
str = "a,b,c,d"
result = str.startswith("a")
Lower 将字符串全体小写
str = "ABCD"
newstr = str.lower()
print(newstr)

// 输出
abcd
Upper 将字符串全体大写
big_str = string.upper()
str = "abcd"
newstr = str.upper()
print(newstr)

// 输出
ABCD
Find 返回想寻找的成员的位置
string.find(item)
注意:字符串里的位置是从左向右,以 0 开始的,空格也算。
str = "abcd"
position = str.find("b")
print(position)

// 输出
1
Index 返回想寻找的成员的位置
string.index(item)
Python 字符串的编码问题
我们都知道计算机只能处理数字,如果要处理文本,就必须先把文本转换为数字才能处理。最早的计算机在设计时采用8个比特(bit)作为一个字节(byte),所以,一个字节能表示的最大的整数就是255(二进制11111111=十进制255),0 - 255被用来表示大小写英文字母、数字和一些符号,这个编码表被称为ASCII编码,比如大写字母 A 的编码是 65,小写字母 z 的编码是 122。
如果要表示中文,显然一个字节是不够的,至少需要两个字节,而且还不能和 ASCII 编码冲突,所以,中国制定了 GB2312 编码,用来把中文编进去。
类似的,日文和韩文等其他语言也有这个问题。为了统一所有文字的编码,Unicode 应运而生。Unicode 把所有语言都统一到一套编码里,这样就不会再有乱码问题了。
Unicode 通常用两个字节表示一个字符,原有的英文编码从单字节变成双字节,只需要把高字节全部填为 0 就可以。
因为 Python 的诞生比 Unicode 标准发布的时间还要早,所以最早的 Python 只支持 ASCII 编码,普通的字符串 ‘ABC’ 在 Python 内部都是 ASCII 编码的。
Python 在后来添加了对 Unicode 的支持,以 Unicode 表示的字符串用u'...'表示。
不过在最新的 Python 3 版本中,字符串是以 Unicode 编码的,也就是说,Python 的字符串支持多语言。就像上面的例子一样,我的代码中没有加 u'...',也能正常显示。
不过由于 Python 源代码也是一个文本文件,所以,当你的源代码中包含中文的时候,在保存源代码时,就需要务必指定保存为 UTF-8 编码。当 Python 解释器读取源代码时,为了让它按 UTF-8 编码读取,我们通常在文件开头写上这两行:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
第一行注释是为了告诉 Linux/OS X 系统,这是一个 Python 可执行程序,Windows 系统会忽略这个注释;
第二行注释是为了告诉 Python 解释器,按照 UTF-8 编码读取源代码,否则,你在源代码中写的中文输出可能会有乱码。
申明了 UTF-8 编码并不意味着你的 .py 文件就是 UTF-8 编码的,必须并且要确保文本编辑器正在使用 UTF-8 without BOM 编码。
字符串的格式化
使用操作符 %
'my name is %s, my age is %s' % ('zhangsan', 18)
字符串格式化函数 format
- string.format 函数用来格式化字符串
- 使用format的字符串主体使用 {} 大括号来替代格式符
- string.format(data, data, data...)
info = 'my name is {0}, my age is {1}, my book is {2}'
print(info.format("zhangsan", 18, "python"))
f-strings(好用)
- 定义一个变量
- 字符串前加f符号
- 需要格式化的位置使用 {变量名}
name = "zhangsan"
age = 18
info = f'my name is {name}, my age is {age}'
print(info)
转义字符
| 符号 | 说明 |
|---|---|
| \n | 换行,一般用于末尾,strip对其也有效 |
| \t | 横向制表符(可以认为是一个间隔符) |
| \v | 纵向制表符(会有一个男性符号) |
| \a | 响铃 |
| \b | 退格符,将光标前移,覆盖(删除前一个) |
| \r | 回车 |
| \f | 翻页(几乎用不到,会出现一个女性符号) |
| \\' | 转义字符串中的单引号 |
| \\" | 转义字符串中的双引号 |
| \\\ | 转义斜杠 |
整数
整数英文为 integer 。
Python 可以处理任意大小的整数,例如:1,100,-8080,0,等等。
注意:如果数字用引号括起来了,那就属于字符串,而不属于整数。比如 '100' , 这是字符串,不是整数。
浮点数
浮点数的英文名是 float ,是指带小数的数字。
浮点数跟整数有很多类似的地方,但是浮点数是最折磨人的,也是最难让人捉摸透的。
就好比世界级的大佬 Herb Sutter 说的:「世上的人可以分为3类:一种是知道自己不懂浮点运算的;一种是以为自己懂浮点运算的;最后一种是极少的专家级人物,他们想知道自己是否有可能,最终完全理解浮点运算。
布尔值
布尔值和布尔代数的表示完全一致,一个布尔值只有 True 、 False两种值,要么是 True,要么是 False,在 Python 中,可以直接用 True、False 表示布尔值(请注意大小写),也可以通过布尔运算计算出来。
布尔值可以用 and、or 和 not 运算。
and 运算是与运算,只有所有都为 True,and 运算结果才是 True。
or 运算是或运算,只要其中有一个为 True,or 运算结果就是 True。
not 运算是非运算,它是一个单目运算符,把 True 变成 False,False 变成 True。
空值
基本上每种编程语言都有自己的特殊值——空值,在 Python 中,用 None 来表示。
列表 List
什么是列表
List (列表)是 Python 内置的一种数据类型。 它是一种有序的集合,可以随时添加和删除其中的元素,且列表中的元素可以重复。
在实际开发中,经常需要将一组(不只一个)数据存储起来,以便后边的代码使用。列表就是这样的一个数据结构。
创建列表
listname = [element1, element2, element3, ..., elementn]
其实列表就是用中括号 [] 括起来的数据,里面的每一个数据就叫做元素。每个元素之间使用逗号分隔。
不同于
C,java等语言的数组,python的列表可以存放不同的,任意的数据类型对象。
list1=['张三', 'lisi', 123]
使用列表推导式创建列表,如:
[x for x in range(1, 10)]
访问列表中的值
我们可以通过列表的下标索引来访问列表中的值,同样你也可以使用方括号的形式截取字符。
例如:
name = ['张三', '李四', '王五']

# 通过索引来访问列表
print(name[1]) # 李四

# 切片操作
# 通过方括号的形式来截取列表中的数据
print(name[0:2]) # 左闭右开,从第 0 个开始取,取到第 2 个,但是不包含第 2 个。# ['张三', '李四']
print(name[1:-1]) # ['李四']
更新列表
可以通过索引对列表的数据项进行修改或更新,也可以使用 append() 方法来添加列表项。
name = ['张三', '李四', '王五']

# 通过索引对列表的数据项进行修改或更新
name[1] = '李4'
print(name)

# 使用 append() 方法来添加列表项
name.append('小明')
print(name)

// 输出
['张三', '李4', '王五']
['张三', '李4', '王五', '小明']
删除列表里面的元素
name = ['张三', '李四', '王五']

print(name)

# 使用 del 语句来删除列表的的元素
del name[2]
print(name)

// 输出
['张三', '李四', '王五']
['张三', '李四']
List 内置方法
len(list)
列表元素个数
max(list)
返回列表元素最大值
min(list)
返回列表元素最小值
list(seq)
将元组转换为列表
append
list.append(obj) 在列表末尾添加新的元素
Count
list.count(obj) 统计某个元素在列表中出现的次数
Insert
list.insert(index, obj) 在 index 位置插入 obj 元素
Pop
list.pop(index) 移除索引对应的元素并且返回该元素的值,不指定索引移除最后一个元素
remove
list.remove(obj) 移除列表中的一个元素(参数是列表中元素),并且不返回任何值
sort
list.sort([func]) 对原列表进行排序
Clear
list.clear 将当前列表清空
元组 Tuple
什么是元组
tuple 和 List 非常类似,但是 tuple 一旦初始化就不能修改,也就是说它也没有 append(),insert() 这样的方法,但它也有获取某个索引值的方法,但是不能赋值。
所以建议能用 tuple 代替 list 就尽量用 tuple 。
创建元组
元组创建很简单,只需要在括号中添加元素,并使用逗号隔开即可。
tuple1=('张三', '李四', '王五', 123, 456)
tuple2='张三', '李四', '王五', 123, 456
创建空元组
tuple3=()
元组中只包含一个元素时,需要在元素后面添加逗号
tuple4=(123,)
如果不加逗号,创建出来的就不是 元组(tuple),而是指 123 这个数了。
这是因为括号 () 既可以表示元组(tuple),又可以表示数学公式中的小括号,这就产生了歧义。
所以如果只有一个元素时,你不加逗号,计算机就根本没法识别你是要进行整数或者小数运算还是表示元组。
因此,Python 规定,这种情况下,按小括号进行计算,计算结果自然是 123 ,而如果要表示元组的时候,就需要加个逗号。
元组中的值
元组下标索引也是从 0 开始,元组(tuple)可以使用下标索引来访问元组中的值。
#-*-coding:utf-8-*-

tuple1=('张三','李四','王五',123,456)
tuple2='张三','李四','王五',123,456

print(tuple1[1])
print(tuple2[0])
修改元组
可能看到这个小标题有人会疑问,上面不是说 tuple 是不可变的吗?这里怎么又修改 tuple 了。
那是因为元组中的元素值是不允许修改的,但我们可以对元组进行连接组合,还有通过修改其他列表的值从而影响 tuple 的值。
具体看下面的这个例子:
#-*-coding:utf-8-*-
list1=[123,456]
tuple1=('张三','李四','王五',list1)
print(tuple1)
list1[0]=789
list1[1]=100
print(tuple1)

// 输出
('张三', '李四', '王五', [123, 456])
('张三', '李四', '王五', [789, 100])
可以看到,两次输出的 tuple 值是变了的。
可以看到,tuple1 有四个元素,最后一个元素是一个 List ,List 列表里有两个元素。
当我们把 List 列表中的两个元素 124 和 456 修改为 789 和 100 的时候,从输出来的 tuple1 的值来看,好像确实是改变了。
但其实变的不是 tuple 的元素,而是 list 的元素。
tuple 一开始指向的 list 并没有改成别的 list,所以,tuple 所谓的“不变”是说,tuple 的每个元素,指向永远不变。注意是 tupe1 中的第四个元素还是指向原来的 list ,是没有变的,我们修改的只是列表 List 里面的元素。
删除元组
tuple 元组中的元素值是不允许删除的,但我们可以使用 del 语句来删除整个元组
#-*-coding:utf-8-*-

tuple1=('张三','zhangsan',[123,456])
print(tuple1)
del tuple1
Tuple 内置方法
| 方法 | 描述 |
|---|---|
| len(tuple) | 计算元组元素个数 |
| max(tuple) | 返回元组中元素最大值 |
| min(tuple) | 返回元组中元素最小值 |
| tuple(seq) | 将列表转换为元组 |
集合 Set
python 的 set 和其他语言类似, 是一个无序不重复元素集, 基本功能包括关系测试和消除重复元素。
set 和 dict 类似,但是 set 不存储 value 值的。
如何创建 set
创建一个 set,需要提供一个 list 作为输入集合
set1=set([123,456,789])
print(set1)

// 输出
{456, 123, 789}
传入的参数 [123,456,789] 是一个 list,而显示的 {456, 123, 789} 只是告诉你这个 set 内部有 456, 123, 789 这 3 个元素,显示的顺序跟你参数中的 list 里的元素的顺序是不一致的,这也说明了 set 是无序的。
还有一点,我们观察到输出的结果是在大括号中的,经过之前的学习可以知道,tuple (元组) 使用小括号,list (列表) 使用方括号, dict (字典) 使用的是大括号,dict 也是无序的,只不过 dict 保存的是 key-value 键值对值,而 set 可以理解为只保存 key 值。
在 dict (字典) 中创建时,有重复的 key ,会被后面的 key-value 值覆盖的,而 重复元素在 set 中自动被过滤的。
如何更新 set
通过 add(key) 方法可以添加元素到 set 中,可以重复添加,但不会有效果
set1=set([123,456,789])
print(set1) # {456, 123, 789}
set1.add(100)
print(set1) # {456, 123, 100, 789}
set1.add(100)
print(set1) # {456, 123, 100, 789}
删除 set 里面的元素
通过 remove(key) 方法可以删除 set 中的元素
set1=set([123,456,789])
print(set1)
set1.remove(456)
print(set1)
字典 Dict
什么是字典
字典是另一种可变容器模型,且可存储任意类型对象。
字典是Python提供的唯一内建的映射(Mapping Type)数据类型。
如何创建 dict
python使用 { } 创建字典,由于字典中每个元素都包含键(key)和值(value)两部分,因此在创建字典时,键和值之间使用冒号:分隔,相邻元素之间使用逗号,分隔,所有元素放在大括号{ }中。
格式如下所示:
dictname = {'key':'value1', 'key2':'value2', ...}
1、同一字典中的各个键必须唯一,不能重复。
2、字典是键值对是无序的,但在3.6版本后,字典默认做成有序的了,这是新的版本特征。
创建 dict(字典)实例:
dict1={'张三':'111111' ,'zhangsan':'222222' ,'sanzhang':'333333'}
dict2={'abc':1234,1234:'abc'}
如何访问 dict
name = {'张三': '131456780001', '李四': '131456780002', '王五': '131456780003', '赵六': '131456780004'}
print(name['李四'])

// 输出
131456780002
这里需要注意的一点是:如果字典中没有这个键,是会报错的。
如何修改 dict
向字典添加新内容的方法是增加新的键/值对,修改或删除已有键/值对
dict1={'张三':'131456780001' ,'李四':'131456780002' ,'王五':'131456780003'}
print(dict1)
# 新增一个键值对
dict1['jack']='444444'
print(dict1)
# 修改键值对
dict1['王五']='555555'
print(dict1)
删除 dict (字典)
通过 del 可以删除 dict (字典)中的某个元素,也能删除 dict (字典)
通过调用 clear() 方法可以清除字典中的所有元素
dict1={'张三':'111111' ,'李四':'222222' ,'王五':'333333'}
print(dict1)
# 通过 key 值,删除对应的元素
del dict1['张三']
print(dict1)
# 删除字典中的所有元素
dict1.clear()
print(dict1)
dict (字典)使用时注意的事项
- dict(字典)是不允许一个键创建两次的,但是在创建 dict (字典)的时候如果出现了一个键值赋予了两次,会以最后一次赋予的值为准
- dict(字典)键必须不可变,可是键可以用数字,字符串或元组充当,但是就是不能使用列表
- dict 内部存放的顺序和 key 放入的顺序是没有任何关系
和 list 比较,dict 有以下几个特点:
- 查找和插入的速度极快,不会随着key的增加而变慢
- 需要占用大量的内存,内存浪费多
而list相反:
- 查找和插入的时间随着元素的增加而增加
- 占用空间小,浪费内存很少
dict (字典) 的函数和方法
| 方法和函数 | 描述 |
|---|---|
| len(dict) | 计算字典元素个数 |
| str(dict) | 输出字典可打印的字符串表示 |
| type(variable) | 返回输入的变量类型,如果变量是字典就返回字典类型 |
| dict.get("key",None) | 查询字典某键的值,取不到返回默认值 |
| dict.setdefault() | 查询字典某键的值,取不到给字典设置键值,同时返回设置的值 |
| dict.clear() | 删除字典内所有元素 |
| dict.update() | 更新字典 |
| dict.copy() | 返回一个字典的浅复制 |
| dict.values() | 以列表返回字典中的所有值 |
| dict.pop() | 删除字典指定的键值对 |
| dict.popitem() | 随机返回并删除字典中的一对键和值 |
| dict.items() | 以列表返回可遍历的(键, 值) 元组数组 |
| dict.keys() | 返回字典所有 key 的伪列表 |
| mail_list |= new_mail_list | 用新字典的“键”和“值”更新旧的字典,新字典的“键”和“值”优先 |
字典进阶使用
# 案例1:列表嵌套字典

data = [
    {"name": "rain", "age": 22},
    {"name": "eric", "age": 32},
    {"name": "alvin", "age": 24},
]

# 循环data,每行按着格式『姓名:rain,年龄:22』将每个学生的信息逐行打印

for stu_dic in data:  # data是一个列表
    # print(stu_dic) #
    print("『姓名:%s,年龄:%s』" % (stu_dic.get("name"), stu_dic.get("age")))

# 将data中第二个学生的年龄查询出来

print(data[1].get("age"))

# 案例2:字典嵌套字典


data2 = {
    1001: {"name": "rain", "age": 22},
    1002: {"name": "eric", "age": 32},
    1003: {"name": "alvin", "age": 24},
}

# 循环data2,每行按着格式『学号1001, 姓名:rain,年龄:22』将每个学生的信息逐行打印

for stu_id, stu_dic in data2.items():
    # print(stu_id,stu_dic)
    name = stu_dic.get("name")
    age = stu_dic.get("age")

    print("『学号: %s, 姓名 %s,年龄:%s』" % (stu_id, name, age))

# name = "yuan"
# age = 22
# sex = "male"
#
# print("『姓名:", name, "年龄:", age, "性别:", sex, "』")
# print("『姓名: %s 年龄: %s  性别: %s 』" % (name, age, sex))
# print("姓名:name")
常见错误错误
- 访问错误
使用内置方法,访问到某个类型不存在的元素
- 列表:IndexError: list index out of range
- 字典:KsyError: 'xxx'
解决办法:
先判断该元素是否存在,再进行操作
元素 in 对象
- 不同数据类型之间操作报错
不同的数据类型之间,能够支持不同功能但相同写法的元素符,如:
\> 、 <、 == 、+、 -
不同类型之间操作会出现报错,如:
1 + 'a'
TypeError: unsupported operatorted operand type(s) for +: 'int' and 'str'
解决办法:
转换为相同的类型
- 对只读类型进行写入
这种错误经常出现在元组类型中,如:
t.append('new_element')
AttributeError: 'tuple' object has no attribute 'append'
解决办法:
写入之前判断类型,type(t)
- 引用错误
常用于不可哈希对象作为字典的键
典型报错:TypeError: unhashable type: 'list'
解决办法:
使用元组、字符串、数字作为字典的键
变量
变量的创建和赋值
在 Python 程序中,变量是用一个变量名表示,可以是任意数据类型,变量名必须是大小写英文、数字和下划线(_)的组合,且不能用数字开头,比如:
age = 18
这里的 age 就是一个变量,代表一个整数,注意 Python 是不用声明数据类型的。在 Python 中 = 是赋值语句,跟其他的编程语言也是一样的,因为 Python 定义变量时不需要声明数据类型,因此可以把任意的数据类型赋值给变量,且同一个变量可以反复赋值,而且可以是不同的数据类型。
变量的指向问题
先看一段代码
a = 'Hello Python'
b = a
a = 123
print(b)
变量 a 一开始是指向了字符串 Hello Python ,b = a 创建了变量 b ,变量 b 也指向了 a 指向的字符串 Hello Python,最后 a = 123,把 变量 a 重新指向了 123,但是 b 此时还是指向原本的 Hello Python ,所以最后输出变量 b 是 Hello Python。
多个变量赋值
Python 允许同时为多个变量赋值。例如:
a = b = c = 1
当然也可以为多个对象指定多个变量。例如:
a, b, c = 1, 2, "Hello Python"
Python 分支语句
3.10 最新引入的语法
match http_response_status:
    case 400:
        print("Bad request")
    case 404:
        print("Not found")
    case 418:
        print("I'm a teapot")
    case _:
        print("Something wrong with the internet")
变量名 _ 为通配符,保证match语句肯定会匹配成功。
可以使用 “|” 在一个模式中组合多个字面值
Python 条件语句
什么是条件语句
Python 条件语句跟其他语言基本一致的,都是通过一条或多条语句的执行结果( True 或者 False )来决定执行的代码块。
Python 程序语言指定任何非 0 和非空(null)值为 True,0 或者 null 为 False。
if 语句的基本形式
Python 中,if 语句的基本形式如下:
if 判断条件:
    执行语句……
else:
    执行语句……
之前的章节也提到过,Python 语言有着严格的缩进要求,因此这里也需要注意缩进,也不要少写了冒号 : 。
if 语句的判断条件可以用>(大于)、<(小于)、==(等于)、>=(大于等于)、<=(小于等于)来表示其关系。
例如:
# -*-coding:utf-8-*-

results=59

if results>=60:
    print ('及格')
else :
    print ('不及格')
输出的结果为:
不及格
上面也说到,非零数值、非空字符串、非空 list 等,判断为 True,否则为 False。因此也可以这样写:
num = 6
if num :
    print('Hello Python')
输出的结果如下:
可见,把结果打印出来了。
那如果我们把 num 改为空字符串呢?
很明显,空字符串是为 False 的,不符合条件语句,因此不会执行到 print('Hello Python') 这段代码。
还有再啰嗦一点,提醒一下,在条件判断代码中的冒号 : 后、下一行内容是一定要缩进的。不缩进是会报错的。
冒号和缩进是一种语法。它会帮助 Python 区分代码之间的层次,理解条件执行的逻辑及先后顺序。
if 语句多个判断条件的形式
有些时候,我们的判断语句不可能只有两个,有些时候需要多个,比如上面的例子中大于 60 的为及格,那我们还要判断大于 90 的为优秀,在 80 到 90 之间的良好呢?
这时候需要用到 if 语句多个判断条件,
用伪代码来表示:
if 判断条件1:
    执行语句1……
elif 判断条件2:
    执行语句2……
elif 判断条件3:
    执行语句3……
else:
    执行语句4……
实例:
# -*-coding:utf-8-*-

results = 89

if results > 90:
    print('优秀')
elif results > 80:
    print('良好')
elif results > 60:
    print ('及格')
else :
    print ('不及格')
输出的结果:
良好
if 语句多个条件同时判断
有时候我们会遇到多个条件的时候该怎么操作呢?
比如说要求 java 和 python 的考试成绩要大于 80 分的时候才算优秀,这时候该怎么做?
这时候我们可以结合 or 和 and 来使用。
or (或)表示两个条件有一个成立时判断条件成功
and (与)表示只有两个条件同时成立的情况下,判断条件才成功。
例如:
# -*-coding:utf-8-*-

java = 86
python = 68if java > 80 and  python > 80:
    print('优秀')
else :
    print('不优秀')

if ( java >= 80  and java < 90 )  or ( python >= 80 and python < 90):
    print('良好')
输出结果:
不优秀
良好
注意:if 有多个条件时可使用括号来区分判断的先后顺序,括号中的判断优先执行,此外 and 和 or 的优先级低于 >(大于)、<(小于)等判断符号,即大于和小于在没有括号的情况下会比与或要优先判断。
if 嵌套
if 嵌套是指什么呢?
就跟字面意思差不多,指 if 语句中可以嵌套 if 语句。
比如上面说到的例子,也可以用 if 嵌套来写。
当然这只是为了说明 if 条件语句是可以嵌套的。如果是这个需求,我个人还是不太建议这样使用 if 嵌套的,因为这样代码量多了,而且嵌套太多,也不方便阅读代码。
如果 if 判断成功后什么也不执行,使用 pass
Python 循环语句
1、什么是循环语句
循环语句允许我们执行一个语句或语句组多次。
在 Python 提供了 for 循环和 while 循环。
这里又有一个问题了,如果我想让他运行了一百次之后停止,那该怎么做呢?
这时候需要用到一些控制循环的语句:
| 循环控制语句 | 描述 |
|---|---|
| break | 在语句块执行过程中终止循环,并且跳出整个循环 |
| continue | 在语句块执行过程中终止当前循环,跳出该次循环,执行下一次循环 |
| pass | pass 是空语句,是为了保持程序结构的完整性 |
这些控制语句是为了让我们告诉程序什么时候停止,什么时候不运行这次循环。
2、for 循环语句
基本的语法格式:
for iterating_var in sequence:
   statements(s)
3、range() 函数
for 循环还常常和 range() 函数搭配使用的。
如果不知道 range() 函数 , 我们直接通过一段程序来理解。
for i in range(3):
    print(i)

// 输出
0
1
2
range 函数还有一个三个参数的。
比如 range(0,10,2) , 它的意思是:从 0 数到 10(不取 10 ),每次间隔为 2 。
4、While 循环语句
5、for 循环和 whlie 循环的区别
之前也提到过了,如果一种语法能表示一个功能,那没必要弄两种语法来表示。
竟然都是循环,for 循环和 while 循环肯定有他们的区别的。
那什么时候才使用 for 循环和 while 循环呢
- for 循环主要用在迭代可迭代对象的情况。
- while 循环主要用在需要满足一定条件为真,反复执行的情况。 (死循环+break 退出等情况。)
- 部分情况下,for 循环和 while 循环可以互换使用。
例如:
for i in range(0, 10):
    print(i)


i = 0
while i < 10:
    print(i)
    i = i + 1
虽然打印的结果是一样的,但是细细品味你会发现,他们执行的顺序和知道的条件是不同的。
6、嵌套循环
循环语句和条件语句一样,都是可以嵌套的。
具体的语法如下:
for 循环嵌套语法
for iterating_var in sequence:
   for iterating_var in sequence:
      statements(s)
   statements(s)
while 循环嵌套语法
while expression:
   while expression:
      statement(s)
   statement(s)
除此之外,你也可以在循环体内嵌入其他的循环体,如在 while 循环中可以嵌入 for 循环, 反之,你可以在 for 循环中嵌入 while 循环
比如:
当我们需要判断 sum 大于 1000 的时候,不在相加时,可以用到 break ,退出整个循环。
count = 1
sum = 0
while (count <= 100):
    sum = sum + count
    if ( sum > 1000):  #当 sum 大于 1000 的时候退出循环break
    count = count + 1
print(sum)
输出的结果:
1035
有时候,我们只想统计 1 到 100 之间的奇数和,那么也就是说当 count 是偶数,也就是双数的时候,我们需要跳出当次的循环,不想加,这时候可以用到 break
count = 1
sum = 0
while (count <= 100):
    if ( count % 2 == 0):  # 双数时跳过输出
        count = count + 1
        continue
    sum = sum + count
    count = count + 1
print(sum)
输出的语句:
2500
还有:
for num in range(10,20):  # 迭代 10 到 20 之间的数字for i in range(2,num): # 根据因子迭代if num%i == 0:      # 确定第一个因子
         j=num/i          # 计算第二个因子print ('%d 是一个合数' % num)
         break            # 跳出当前循环else:                  # 循环的 else 部分print ('%d 是一个质数' % num)
输出的结果:
10 是一个合数
11 是一个质数
12 是一个合数
13 是一个质数
14 是一个合数
15 是一个合数
16 是一个合数
17 是一个质数
18 是一个合数
19 是一个质数
当然,这里还用到了 for … else 语句。
其实 for 循环中的语句和普通的没有区别,else 中的语句会在循环正常执行完(即 for 不是通过 break 跳出而中断的)的情况下执行。
当然有 for … else ,也会有 while … else 。他们的意思都是一样的。
输入输出与文件操作
编码
ASCII表
众所周知,计算机起源于美国,英文只有26个字符,算上其他所有特殊符号也不会超过128个。字节是计算机的基本储存单位,一个字节(bytes)包括八个比特位(bit),能够表示出256个二进制数字,所以美国人在这里只是用到了一个字节的前七位即127个数字来对应了127个具体字符,而这张对应表就是ASCII码字符编码表,简称ASCII表。后来为了能够让计算机识别拉丁文,就将一个字节的最高位也应用了,这样就多扩展出128个二进制数字来对应新的符号。这张对应表因为是在ASCII表的基础上扩展的最高位,因此称为扩展ASCII表。到此位置,一个字节能表示的256个二进制数字都有了特殊的符号对应。
GBK编码
但是,当计算机发展到东亚国家后,问题又出现了,像中文,韩文,日文等符号也需要在计算机上显示。可是一个字节已经被西方国家占满了。于是,我中华民族自己重写一张对应表,直接生猛地将扩展的第八位对应拉丁文全部删掉,规定一个小于127的字符的意义与原来相同,即支持ASCII码表,但两个大于127的字符连在一起时,就表示一个汉字,这样就可以将几千个汉字对应一个个二进制数了。而这种编码方式就是GB2312,也称为中文扩展ASCII码表。再后来,我们为了对应更多的汉字规定只要第一个字节是大于127就固定表示这是一个汉字的开始,不管后面跟的是不是扩展字符集里的内容。这样能多出几万个二进制数字,就算甲骨文也能够用了。而这次扩展的编码方式称为GBK标准。当然,GBK标准下,一个像”苑”这样的中文符号,必须占两个字节才能存储显示。
Unicode与utf8编码
与此同时,其它国家也都开发出一套编码方式,即本国文字符号和二进制数字的对应表。而国家彼此间的编码方式是互不支持的,这会导致很多问题。于是ISO国际化标准组织为了统一编码,统计了世界上所有国家的字符,开发出了一张万国码字符表,用两个字节即六万多个二进制数字来对应。这就是Unicode编码方式。这样,每个国家都使用这套编码方式就再也不会有计算机的编码问题了。Unicode的编码特点是对于任意一个字符,都需要两个字节来存储。这对于美国人而言无异于吃上了世界的大锅饭,也就是说,如果用ASCII码表,明明一个字节就可以存储的字符现在为了兼容其他语言而需要两个字节了,比如字母I,本可以用01001001来存储,现在要用Unicode只能是00000000 01001001存储,而这将导致大量的空间被浪费掉。基于此,美国人创建了utf8编码,而utf8编码是一种针对Unicode的可变长字符编码方式,根据具体不同的字符计算出需要的字节,对于ASCII码范围的字符,就用一个字节,而且符号与数字的对应也是一致的,所以说utf8是兼容ASCII码表的。但是对于中文,一般是用三个字节存储的。
编码和解码
s = "张三"
b1 = s.encode()
b2 = s.encode("GBK")
print(b1) # 默认utf8 : b'\xe8\x8b\x91\xe6\x98\x8a'
print(b2) # b'\xd4\xb7\xea\xbb'

print(b1.decode()) # 这里如果用GBK解码就会出现乱码
print(b2.decode("GBK"))

print(type(b1)) # <class 'bytes'>
print(type(b2)) # <class 'bytes'>
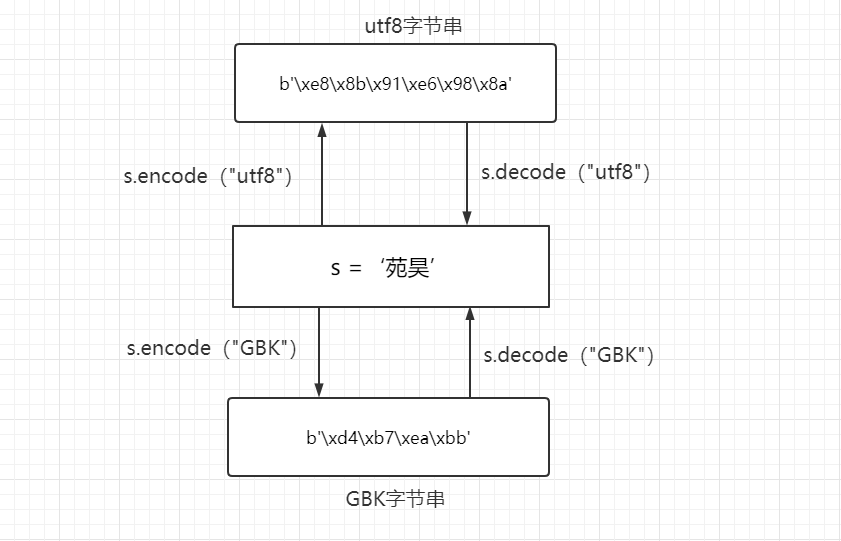
Python 3 最重要的新特性大概要算是对文本和二进制数据作了更为清晰的区分,不再会对bytes字节串进行自动解码。文本总是Unicode,由str类型表示,二进制数据则由bytes类型表示。Python 3不会以任意隐式的方式混用str和bytes,正是这使得两者的区分特别清晰。
输入
一个程序如果使用文件作为输入系统要考虑的三件事:文件是否存在,文件是否有可读权限,使用正确的文件编码。
文件是否存在
import pathlib
import sys

path = pathlib.Path("d:\\ab.txt")

if path.is_file():
    print(f"{path} 是文件")
else:
    print(f"{path} 不是文件, 请重新创建文件")
    # 退出程序
    sys.exit(1)
文件是否有可读取权限
import pathlib
import os

path = pathlib.Path("d:\\a.txt")

if os.access(path, os.R_OK):
    print("文件可以读取")

if os.access(path, os.W_OK):
    print("文件可以写入")
正确的文件编码
# pip3 install chardet
# chardet 是第三方库,需要通过 pip 命令为 Python 安装后使用

from chardet.universaldetector import UniversalDetector

detector = UniversalDetector()

with open("d:\\temp\\a.txt", "rb") as f:
    detector.feed(f.read())
    detector.close()

    print(detector.result)
# {'encoding': 'utf-8', 'confidence': 0.7525, 'language': ''}
以上代码,对文件进行判断之后,通过 detector.result 得到一个字典,其中字典 encoding 键对应的值就是文件的编码,我将这段代码运行在 Windows 上面,如果文件为 utf-8 编码,打开文件时在 open() 函数中增加 encoding=utf8 参数,否则不加。
打开文件
在 Python中,如果想要操作文件,首先需要创建或者打开指定的文件,并创建一个文件对象,而这些工作可以通过内置的 open() 函数实现。open() 函数用于创建或打开指定文件,该函数的常用语法格式如下:
file = open(file_name [, mode='r' [ , buffering=-1 [ , encoding = None ]]])
此格式中,用 [] 括起来的部分为可选参数,即可以使用也可以省略。其中,各个参数所代表的含义如下:
'''
- file:表示要创建的文件对象。
- file_name:要创建或打开文件的文件名称,该名称要用引号(单引号或双引号都可以)括起来。需要注意的是,如果要打开的文件和当前执行的代码文件位于同一目录,则直接写文件名即可;否则,此参数需要指定打开文件所在的完整路径。
- mode:可选参数,用于指定文件的打开模式。可选的打开模式如表 1 所示。如果不写,则默认以只读(r)模式打开文件。
- buffering:可选参数,用于指定对文件做读写操作时,是否使用缓冲区。
- encoding:手动设定打开文件时所使用的编码格式,不同平台的 ecoding 参数值也不同,以 Windows 为例,其默认为 cp936(实际上就是 GBK 编码)。
'''
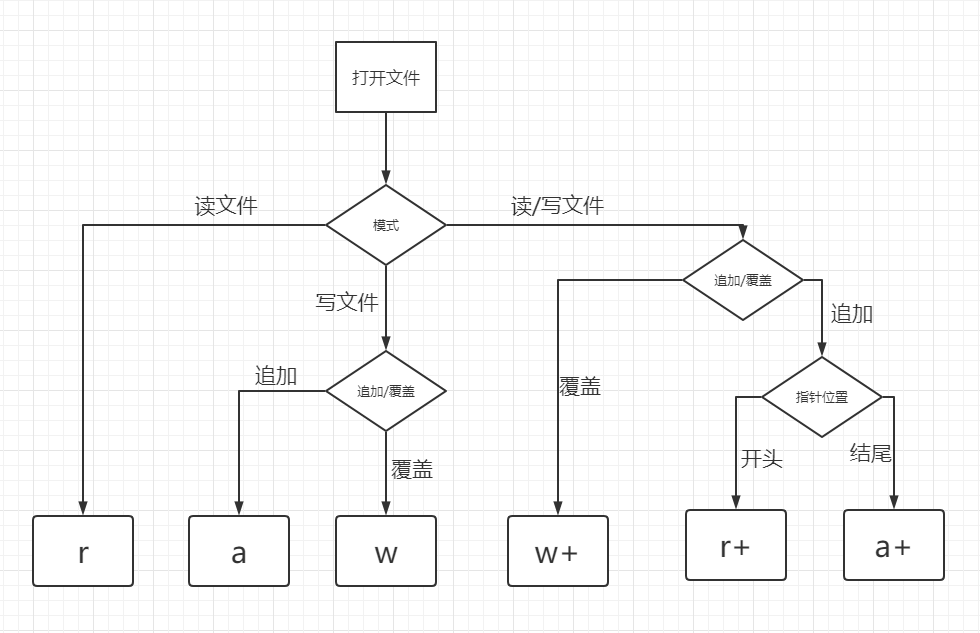
open() 函数支持的文件打开模式如表 1 所示。
| 模式 | 意义 | 注意事项 |
|---|---|---|
| r | 只读模式打开文件,读文件内容的指针会放在文件的开头。 | 操作的文件必须存在。 |
rb |
以二进制格式、采用只读模式打开文件,读文件内容的指针位于文件的开头,一般用于非文本文件,如图片文件、音频文件等。 | |
| r+ | 打开文件后,既可以从头读取文件内容,也可以从开头向文件中写入新的内容,写入的新内容会覆盖文件中等长度的原有内容。 | |
rb+ |
以二进制格式、采用读写模式打开文件,读写文件的指针会放在文件的开头,通常针对非文本文件(如音频文件)。 | |
| w | 以只写模式打开文件,若该文件存在,打开时会清空文件中原有的内容。 | 若文件存在,会清空其原有内容(覆盖文件);反之,则创建新文件。 |
wb |
以二进制格式、只写模式打开文件,一般用于非文本文件(如音频文件) | |
| w+ | 打开文件后,会对原有内容进行清空,并对该文件有读写权限。 | |
wb+ |
以二进制格式、读写模式打开文件,一般用于非文本文件 | |
| a | 以追加模式打开一个文件,对文件只有写入权限,如果文件已经存在,文件指针将放在文件的末尾(即新写入内容会位于已有内容之后);反之,则会创建新文件。 | |
| ab | 以二进制格式打开文件,并采用追加模式,对文件只有写权限。如果该文件已存在,文件指针位于文件末尾(新写入文件会位于已有内容之后);反之,则创建新文件。 | |
| a+ | 以读写模式打开文件;如果文件存在,文件指针放在文件的末尾(新写入文件会位于已有内容之后);反之,则创建新文件。 | |
| ab+ | 以二进制模式打开文件,并采用追加模式,对文件具有读写权限,如果文件存在,则文件指针位于文件的末尾(新写入文件会位于已有内容之后);反之,则创建新文件。 |
将以上几个容易混淆的文件打开模式的功能做了很好的对比:
open()返回的文件对象常用的属性:
'''
- file.name:返回文件的名称;
- file.mode:返回打开文件时,采用的文件打开模式;
- file.encoding:返回打开文件时使用的编码格式;
- file.closed:判断文件是否己经关闭。
'''
注意,当操作文件结束后,必须调用 close() 函数手动将打开的文件进行关闭,这样可以避免程序发生不必要的错误。
读文件
Python提供了如下 3 种函数,它们都可以帮我们实现读取文件中数据的操作:
read()函数:逐个字节或者字符读取文件中的内容;readline()函数:逐行读取文件中的内容;readlines()函数:一次性读取文件中多行内容。
# (1) 读字符
f = open("满江红",encoding="utf8")

print(f.read()) # 默认读取所有字符
print(f.read(3))
print(f.readline())
print(f.readlines())

# (2) 读字节
f = open("满江红",mode="rb")
print(f.read())
print(f.read(2))
print(f.read(3))
print(f.read(2).decode())
print(f.read(12).decode())

# (3) 循环读文件
f = open("满江红",encoding="utf8")
for line in f.readlines():
    print(line,end="")

for line in f:
    print(line,end="")
输出
使用文件作为输出时,也要考虑两件事:文件要保存的文件夹是否存在;如果文件夹不存在,你要如何创建文件夹。
import pathlib
import sys
import os

dir = "d:\\dir1\\dir2"
path = pathlib.Path(dir)
if path.is_dir():
    print(f"{path} 文件夹存在")

else:
    print(f"文件夹不存在,创建{path} 文件夹")

    # 创建多级文件夹
    os.makedirs(dir)
以上代码实现了判断文件夹是否存在,如果不存在的话自动创建多级文件夹操作。
上面代码的第 7 行和第 14 行需要你特别注意,其中第 7 行实现了对文件夹类型的判断。第 14 行使用了 os 库的 makedirs() 函数创建多级文件夹。os 库创建文件夹有两个函数,分别为 mkdir() 和 makedirs() ,前者可以创建一级文件夹,后者可以创建多级文件夹。当你需要创建文件夹时,可以根据不同的需求使用不同的函数。
写文件
f = open("满江红new",mode="w",encoding="utf8") #  w:覆盖模式  a:  追加模式
f.write("怒发冲冠,凭栏处、潇潇雨歇。\n")
f.writelines(["抬望眼,","仰天长啸,壮怀激烈"]) # 将字符串列表写入文件中
f.flush()
import time
time.sleep(100)
f.close() # 没有close,只有在程序退出时才会被释放掉
input()函数
命令行参数 argparse
import argparse

parser = argparse.ArgumentParser(description="这个程序用来演示 argparse 的用法")
parser.add_argument("echo", help="echo the string you use here")
parser.add_argument("-v", "--verbosity", type=int, choices=[0, 1, 2], help="increase output verbosity")
args = parser.parse_args()
print(args.echo)
三种常用的格式化输出方式
-
百分号 %
-
format() 函数
- https://docs.python.org/zh-cn/3.10/library/stdtypes.html#str.format
-
f-strings(推荐方法)
- F-strings 是 Python3.6 新增的字符串格式化功能
- 比百分号和 str.format() 更友好
- 采用了早期为字符串添加关键字方式,如“u”、"r”、“b"
- 官方文档:https://peps.python.org/pep-0498
- F-strings 的{}可以实现数字计算、字符串连接、函执行等计算任务
- 嵌入的内容可解释执行
f"{1 + 2}"
f"{'a' + 'b'}"
f"{print('c')}"

print(f"我的名字叫{name},我的年龄{age}!")
print() 函数
print() 函数由两部分构成 :
- 指令:print
- 指令的执行对象,在 print 后面的括号里的内容
而 print() 函数的作用是让计算机把你给它的指令结果,显示在屏幕的终端上。这里的指令就是你在 print() 函数里的内容。
比如在上一章节中,我们的第一个 Python 程序,打印 print('Hello Python')
它的执行流程如下:
- 向解释器发出指令,打印 ‘Hello Python’
- 解析器把代码解释为计算器能读懂的机器语言
- 计算机执行完后就打印结果
可能这里有人会问,为什么要加单引号,直接 print(Hello Python) 不行吗?
如果你写代码过程中,有这样的疑问,直接写一下代码,自己验证一下是最好的。
显然,去掉单引号后,运行结果标红了(报错),证明这是不可以的。
主要是因为这不符合 Python 的语法规则,去掉单引号后, Python 解释器根本没法看懂你写的是什么。
所以就报 SyntaxError: invalid syntax 的错误,意思是:语法错误。说明你的语句不合规则。
使用 open() 函数打开文件
file_handler = open("afile")

//返回内容
name='a.file' mode='r' ecoding='UTF-8'
- 如果没有报错,文件打开成功
- 为了避免误操作,默认为只读方式打开文件
文件路径处理
如果打开文件的路径不正确,会提示如下错误:
FileNotFoundError: [Errno 2] No such file or directory: 'xxx.filet'
解决办法:
打开文件时增加路径
进入指定路径后,再打开文件
file_handler = open("/tmp/afile")

import os
os.chdir("/tmp")
file_handler = open("afile")
文件打开模式
file_handler = open("/tmp/afile", mode="r")
Python 函数
什么是函数
函数,其实我们一开始学 Python 的时候就接触过,不过我们使用的大多数都是 Python 的内置函数。比如基本每个章节都会出现的 print() 函数。
而现在,我们主要学习的是自定义函数。
各位有没有想过为什么需要函数呢?
如果要想回答这个问题,我们需要先了解函数是什么?
函数就是组织好的,可重复使用的,用来实现单一,或相关联功能的代码段。
没错,函数其实就是把代码抽象出来的代码段。
那为什么要抽象出来呢?
方便我们使用,方便我们重复使用。
函数的本质就是我们把一些数据喂给函数,让他内部消化,然后吐出你想要的东西,至于他怎么消化的,我们不需要知道,它内部解决。
怎么理解这句话呢?
举个例子,好比每次用到的 print 函数,我们都知道这个函数的作用是可以把我们的数据输出到控制台,让我们看到。所以 print('两点水') , 我们想打印 两点水 出来,就把 两点水 这个数据喂给 print 函数,然后他就直接把结果打印到控制台上了。
怎么自定义函数
怎么自定义函数?
要知道怎么定义函数,就要知道函数的组成部分是怎样的。
def 函数名(参数1,参数2....参数n):
    函数体
    return 语句
这就是 Python 函数的组成部分。
所以自定义函数,基本有以下规则步骤:
- 函数代码块以 def 关键词开头,后接函数标识符名称和圆括号()
- 任何传入参数和自变量必须放在圆括号中间。圆括号之间可以用于定义参数
- 函数的第一行语句可以选择性地使用文档字符串(用于存放函数说明)
- 函数内容以冒号起始,并且缩进
- return [表达式] 结束函数,选择性地返回一个值给调用方。不带表达式的 return 相当于返回 None。
语法示例:
def functionname( parameters ):"函数_文档字符串"
   function_suite
   return [expression]
实例:
- def 定义一个函数,给定一个函数名 sum
- 声明两个参数 num1 和 num2
- 函数的第一行语句进行函数说明:两数之和
- 最终 return 语句结束函数,并返回两数之和
def sum(num1,num2):"两数之和"return num1+num2

# 调用函数
print(sum(5,6))
输出结果:
11
函数返回值
基本使用
具体示例:
# -*- coding: UTF-8 -*-
def add(x, y):
    return x + y  # return是函数的终止语句


ret = add(2, 3)
print(ret)
返回结果:
5
Python 语言中的函数返回值可以是多个,而其他语言都不行,这是Python 相比其他语言的简便和灵活之处。
不知道此刻你还记不记得元组的相关知识,如果不记得,建议现在立刻写几个例子回忆一下,比如如何获取元组的第一个元素出来。
默认返回值
在 Python 中,有一个特殊的常量 None(N 必须大写)。和 False 不同,它不表示 0,也不表示空字符串,而表示没有值,也就是空值。None 是 NoneType数据类型的唯一值(其他编程语言可能称这个值为 null、nil 或 undefined),也就是说,我们不能再创建其它 NoneType类型的变量,但是可以将 None 赋值给任何变量。
Python一个函数中如果没有return语句或者return后没有具体值,都默认返回None,比如print()函数就没有返回。
返回多个值
return也可以返回多个值,python其实会将多个值放在一个元组中元组返回。
def login(user,pwd):

        flag = False

        if user == 'yuan' and pwd == 123:
                flag = True

        return flag,user

# ret = login("yuan",123)
flag,user = login("yuan",123)

if flag:
        print("{}登陆成功!".format(user))
else:
        print("用户名或者密码错误!")
函数的参数
1、函数的参数类型
设置与传递参数是函数的重点,而 Python 的函数对参数的支持非常的灵活。
主要的参数类型有:默认参数、关键字参数(位置参数)、不定长参数。
下面我们将一一了解这几种参数。
2、默认参数
有时候,我们自定义的函数中,如果调用的时候没有设置参数,需要给个默认值,这时候就需要用到默认值参数了。
默认参数,只要在构造函数参数的时候,给参数赋值就可以了
例如:
# -*- coding: UTF-8 -*-
def print_user_info( name , age , sex = '男' ):
    # 打印用户信息
    print('昵称:{}'.format(name) , end = ' ')
    print('年龄:{}'.format(age) , end = ' ')
    print('性别:{}'.format(sex))
    return;

# 调用 print_user_info 函数

print_user_info( '张三' , 18 , '女')
print_user_info( '张三' , 25 )
输出结果:
昵称:张三 年龄:18 性别:女
昵称:张三 年龄:25 性别:男
从输出结果可以看到,当你设置了默认参数的时候,在调用函数的时候,不传该参数,就会使用默认值。
但是这里需要注意的一点是:只有在形参表末尾的那些参数可以有默认参数值,也就是说你不能在声明函数形参的时候,先声明有默认值的形参而后声明没有默认值的形参。
这是因为赋给形参的值是根据位置而赋值的。例如,def func(a, b=1) 是有效的,但是 def func(a=1, b) 是 无效 的。
默认值参数就这样结束了吗?
还没有的,细想一下,如果参数中是一个可修改的容器比如一个 list (列表)或者 dict (字典),那么我们使用什么来作为默认值呢?
我们可以使用 None 作为默认值。就像下面这个例子一样:
# 如果 b 是一个 list ,可以使用 None 作为默认值
def print_info( a , b = None ):
    if b is None :
        b=[]
    return;
认真看下例子,会不会有这样的疑问呢?在参数中我们直接 b=[] 不就行了吗?
也就是写成下面这个样子:
def print_info( a , b = [] ):
    return;
对不对呢?
运行一下也没发现错误啊,可以这样写吗?
这里需要特别注意的一点:默认参数的值是不可变的对象,比如None、True、False、数字或字符串,如果你像上面的那样操作,当默认值在其他地方被修改后你将会遇到各种麻烦。
这些修改会影响到下次调用这个函数时的默认值。
示例如下:
# -*- coding: UTF-8 -*-
def print_info( a , b = [] ):
    print(b)
    return b ;

result = print_info(1)

result.append('error')

print_info(2)
输出的结果:
[]
['error']
认真观察,你会发现第二次输出的值根本不是你想要的,因此切忌不能这样操作。
还有一点,有时候我就是不想要默认值啊,只是想单单判断默认参数有没有值传递进来,那该怎么办?
我们可以这样做:
_no_value =object()

def print_info( a , b = _no_value ):
    if b is _no_value :
        print('b 没有赋值')
    return;
这里的 object 是 python 中所有类的基类。 你可以创建 object 类的实例,但是这些实例没什么实际用处,因为它并没有任何有用的方法, 也没有任何实例数据(因为它没有任何的实例字典,你甚至都不能设置任何属性值)。 你唯一能做的就是测试同一性。也正好利用这个特性,来判断是否有值输入。
3、关键字参数(位置参数)
一般情况下,我们需要给函数传参的时候,是要按顺序来的,如果不对应顺序,就会传错值。
不过在 Python 中,可以通过参数名来给函数传递参数,而不用关心参数列表定义时的顺序,这被称之为关键字参数。
使用关键参数有两个优势 :
- 由于我们不必担心参数的顺序,使用函数变得更加简单了。
- 假设其他参数都有默认值,我们可以只给我们想要的那些参数赋值
具体看例子:
# -*- coding: UTF-8 -*-
def print_user_info( name ,  age  , sex = '男' ):
    # 打印用户信息
    print('昵称:{}'.format(name) , end = ' ')
    print('年龄:{}'.format(age) , end = ' ')
    print('性别:{}'.format(sex))
    return;

# 调用 print_user_info 函数

print_user_info( name = '张三' ,age = 18 , sex = '女')
print_user_info( name = '张三' ,sex = '女', age = 18 )
输出的值:
昵称:张三 年龄:18 性别:女
昵称:张三 年龄:18 性别:女
不定长参数
或许有些时候,我们在设计函数的时候,我们有时候无法确定传入的参数个数。
那么我们就可以使用不定长参数。
Python 提供了一种元组的方式来接受没有直接定义的参数。这种方式在参数前边加星号 * 。
如果在函数调用时没有指定参数,它就是一个空元组。我们也可以不向函数传递未命名的变量。
在函数定义中使用*args和**kwargs传递可变长参数。*args用作传递非命名键值可变长参数列表(位置参数);**kwargs用作传递键值可变长参数列表。*args 的参数会以元组(tuple)的形式导入,存放所有未命名的变量参数。**kwargs的参数会以字典的形式导入。
例如:
# -*- coding: UTF-8 -*-
def print_user_info(name, age, sex='男', *hobby):
    # 打印用户信息
    print('昵称:{}'.format(name), end=' ')
    print('年龄:{}'.format(age), end=' ')
    print('性别:{}'.format(sex), end=' ')
    print('爱好:{}'.format(hobby))
    return;


# 调用 print_user_info 函数
print_user_info('张三', 18, '女', '打篮球', '打羽毛球', '跑步')
输出的结果:
昵称:张三 年龄:18 性别:女 爱好:('打篮球', '打羽毛球', '跑步')
通过输出的结果可以知道,*hobby是可变参数,且 hobby 其实就是一个 tuple (元祖)
可变长参数也支持关键字参数(位置参数),没有被定义的关键参数会被放到一个字典里。
这种方式即是在参数前边加 **,更改上面的示例如下:
# -*- coding: UTF-8 -*-
def print_user_info(name, age, sex='男', **hobby):
    # 打印用户信息
    print('昵称:{}'.format(name), end=' ')
    print('年龄:{}'.format(age), end=' ')
    print('性别:{}'.format(sex), end=' ')
    print('爱好:{}'.format(hobby))
    return;


# 调用 print_user_info 函数
print_user_info(name='张三', age=18, sex='女', hobby=('打篮球', '打羽毛球', '跑步'))
输出的结果:
昵称:张三 年龄:18 性别:女 爱好:{'hobby': ('打篮球', '打羽毛球', '跑步')}
通过对比上面的例子和这个例子,可以知道,*hobby是可变参数,且 hobby其实就是一个 tuple (元祖),**hobby是关键字参数,且 hobby 就是一个 dict (字典)
# **kwargs
def print_stu_info(**kwargs,):
    print(kwargs)

print_stu_info(name="张三",height=190)
同时使用*args和**kwargs:
def print_stu_info(name, age=18, *args, **kwargs):
    print(name, age)
    print(args)
    print(kwargs)

print_stu_info("yuan", 20, "China", "Beijing", height="188cm", weight="60kg")
注意点:
1、参数
arg、*args、**kwargs三个参数的位置必须是一定的。必须是(arg,*args,**kwargs)这个顺序,否则程序会报错。2、不定长参数的长度可以为零。
3、
args和kwargs其实只是编程人员约定的变量名字,args是 arguments 的缩写,表示位置参数;kwargs是 keyword arguments 的缩写,表示关键字参数。
5、只接受关键字参数
关键字参数使用起来简单,不容易参数出错,那么有些时候,我们定义的函数希望某些参数强制使用关键字参数传递,这时候该怎么办呢?
将强制关键字参数放到某个*参数或者单个*后面就能达到这种效果,比如:
# -*- coding: UTF-8 -*-
def print_user_info( name , *, age  , sex = '男' ):
    # 打印用户信息
    print('昵称:{}'.format(name) , end = ' ')
    print('年龄:{}'.format(age) , end = ' ')
    print('性别:{}'.format(sex))
    return;

# 调用 print_user_info 函数
print_user_info( name = '两点水' ,age = 18 , sex = '女' )

# 这种写法会报错,因为 age ,sex 这两个参数强制使用关键字参数#print_user_info( '两点水' , 18 , '女' )
print_user_info('两点水',age='22',sex='男')
通过例子可以看,如果 age , sex 不使用关键字参数是会报错的。
很多情况下,使用强制关键字参数会比使用位置参数表意更加清晰,程序也更加具有可读性。使用强制关键字参数也会比使用 **kw 参数更好且强制关键字参数在一些更高级场合同样也很有用。
函数传值问题
先看一个例子:
# -*- coding: UTF-8 -*-
def chagne_number( b ):
    b = 1000

b = 1
chagne_number(b)
print( b )
最后输出的结果为:
1
先看看运行的结果?
想一下为什么打印的结果是 1 ,而不是 1000 ?
其实把问题归根结底就是,为什么通过函数 chagne_number 没有更改到 b 的值?
这个问题很多编程语言都会讲到,原理解释也是差不多的。
这里主要是函数参数的传递中,传递的是类型对象,之前也介绍了 Python 中基本的数据类型等。而这些类型对象可以分为可更改类型和不可更改的类型
在 Python 中,字符串,整形,浮点型**,****tuple** 是不可更改的对象,而 list , dict 等是可以更改的对象。
例如:
不可更改的类型:变量赋值 a = 1,其实就是生成一个整形对象 1 ,然后变量 a 指向 1,当 a = 1000 其实就是再生成一个整形对象 1000,然后改变 a 的指向,不再指向整形对象 1 ,而是指向 1000,最后 1 会被丢弃
可更改的类型:变量赋值 a = [1,2,3,4,5,6] ,就是生成一个对象 list ,list 里面有 6 个元素,而变量 a 指向 list ,a[2] = 5则是将 list a 的第三个元素值更改,这里跟上面是不同的,并不是将 a 重新指向,而是直接修改 list 中的元素值。
这也将影响到函数中参数的传递了:
不可更改的类型:类似 c++ 的值传递,如 整数、字符串、元组。如fun(a),传递的只是 a 的值,没有影响 a 对象本身。比如在 fun(a)内部修改 a 的值,只是修改另一个复制的对象,不会影响 a 本身。
可更改的类型:类似 c++ 的引用传递,如 列表,字典。如 fun(a),则是将 a 真正的传过去,修改后 fun 外部的 a 也会受影响
因此,在一开始的例子中,b = 1,创建了一个整形对象 1 ,变量 b 指向了这个对象,然后通过函数 chagne_number 时,按传值的方式复制了变量 b ,传递的只是 b 的值,并没有影响到 b 的本身。具体可以看下修改后的实例,通过打印的结果更好的理解。
# -*- coding: UTF-8 -*-
def chagne_number( b ):
    print('函数中一开始 b 的值:{}' .format( b ) )
    b = 1000
    print('函数中 b 赋值后的值:{}' .format( b ) )


b = 1
chagne_number( b )
print( '最后输出 b 的值:{}' .format( b )  )
打印的结果:
函数中一开始 b 的值:1
函数中 b 赋值后的值:1000
最后输出 b 的值:1
当然,如果参数中的是可更改的类型,那么调用了这个函数后,原来的值也会被更改,具体实例如下:
# -*- coding: UTF-8 -*-
def chagne_list( b ):
    print('函数中一开始 b 的值:{}' .format( b ) )
    b.append(1000)
    print('函数中 b 赋值后的值:{}' .format( b ) )


b = [1,2,3,4,5]
chagne_list( b )
print( '最后输出 b 的值:{}' .format( b )  )
输出的结果:
函数中一开始 b 的值:[1, 2, 3, 4, 5]
函数中 b 赋值后的值:[1, 2, 3, 4, 5, 1000]
最后输出 b 的值:[1, 2, 3, 4, 5, 1000]
匿名函数
有没有想过定义一个很短的回调函数,但又不想用 def 的形式去写一个那么长的函数,那么有没有快捷方式呢?
答案是有的。
python 使用 lambda 来创建匿名函数,也就是不再使用 def 语句这样标准的形式定义一个函数。
匿名函数主要有以下特点:
- lambda 只是一个表达式,函数体比 def 简单很多。
- lambda 的主体是一个表达式,而不是一个代码块。仅仅能在 lambda 表达式中封装有限的逻辑进去。
- lambda 函数拥有自己的命名空间,且不能访问自有参数列表之外或全局命名空间里的参数。
基本语法
lambda [arg1 [,arg2,.....argn]]:expression
示例:
# -*- coding: UTF-8 -*-

sum = lambda num1 , num2 : num1 + num2;

print( sum( 1 , 2 ) )
输出的结果:
3
注意:尽管 lambda 表达式允许你定义简单函数,但是它的使用是有限制的。 你只能指定单个表达式,它的值就是最后的返回值。也就是说不能包含其他的语言特性了, 包括多个语句、条件表达式、迭代以及异常处理等等。
匿名函数中,有一个特别需要注意的问题,比如,把上面的例子改一下:
# -*- coding: UTF-8 -*-

num2 = 100
sum1 = lambda num1 : num1 + num2 ;

num2 = 10000
sum2 = lambda num1 : num1 + num2 ;

print( sum1( 1 ) )
print( sum2( 1 ) )
你会认为输出什么呢?第一个输出是 101,第二个是 10001,结果不是的,输出的结果是这样:
10001
10001
这主要在于 lambda 表达式中的 num2 是一个自由变量,在运行时绑定值,而不是定义时就绑定,这跟函数的默认值参数定义是不同的。所以建议还是遇到这种情况还是使用第一种解法。
高阶函数
- 高阶函数通常指的是 map、filter、reduce
- map、filter 是内置函数,可以直接使用
- reduce 需要通过 fuctools 库导入
函数对象和函数调用
def foo():
    print("foo 函数被执行")
- 函数调用:
foo()
- 函数对象:
var = foo
var()